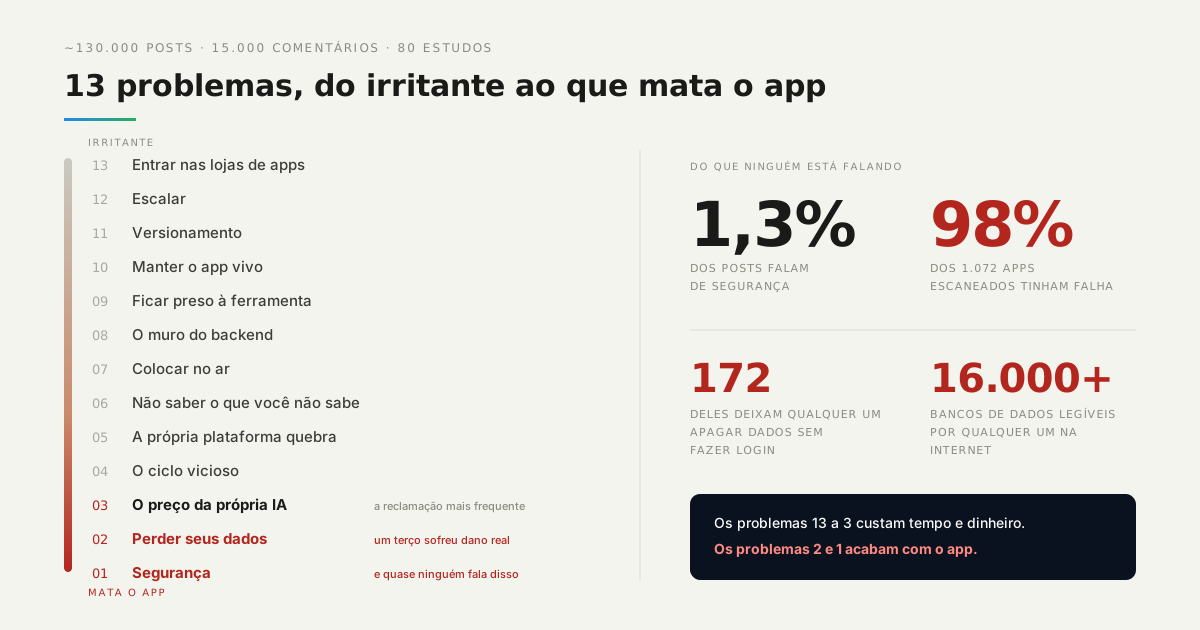
Lemos quase 130.000 posts de vibe coders no Reddit, mais 15.000 comentários em vídeos e 80 estudos do setor. Um achado se destacou, e não é um achado confortável.
Os problemas de que as pessoas mais reclamam não são os que mais machucam. Só 1,3% dos posts falam de segurança. Mas, quando pesquisadores escanearam mais de mil apps feitos com IA, 98% tinham uma falha de segurança.
Então aqui vai a contagem regressiva: treze problemas, do irritante ao que mata o app, com o que fazer em cada caso. Onde um backend gerenciado elimina o problema, dizemos como. Onde não elimina, dizemos isso também.
Prefere assistir?
A mesma contagem regressiva, narrada, com os números por trás de cada posição.

13. Entrar nas lojas de apps
O Google Play exige doze testadores antes de você publicar. A Apple rejeita de cara wrappers finos em volta de um site. Ser rejeitado é frustrante e custa semanas.
É aqui que um web app brilha: ninguém precisa aprovar. Você publica e pronto, cobrindo PCs, Macs, Android e iOS de uma vez.
Se você quiser mesmo um app nativo, não precisa escolher. Um backend com SDKs e APIs REST e GraphQL serve um build web e um build nativo a partir dos mesmos dados, e a loja vira uma decisão de distribuição, não uma reescrita.
12. Escalar
Esse é um problema bom, porque significa que você tem usuários. As histórias típicas são menos animadoras: um banco de dados a 100% de CPU sem ninguém online, ou recursos em tempo real travando com oitenta usuários simultâneos.
Quase sempre a causa é o formato de uma query, não o volume de tráfego: um campo sem índice, ou uma leitura que roda uma vez por linha em vez de uma vez por página.
O que você não quer é que crescer signifique reescrever. Num backend gerenciado, os servidores de banco de dados e a infraestrutura são operados para você; quando você cresce, muda de plano, não de arquitetura.
11. Versionamento
A maioria das pessoas que constroem com IA não versiona o código até perder alguma coisa. Aí voltar atrás vira arqueologia: não existe um último estado bom para onde retornar, só uma pasta que um dia funcionou.
O hábito é a solução, e o hábito é barato. Faça commit antes de cada prompt, não depois de cada funcionalidade, para que cada edição da IA fique no próprio diff, que você consegue ler e reverter.
Plataformas que versionam cada deploy automaticamente dão a mesma rede de proteção para o que está rodando de fato. Algo quebrou? Volte para o último deploy que funcionava e olhe o diff depois.
10. Manter o app vivo
Código espaguete, pacotes que ficaram desatualizados seis meses atrás e apps que caem sem ninguém perceber até um usuário comentar.
O terceiro é o problema de verdade. Um app que ninguém está olhando é um app cujas quedas duram o tempo que alguém leva para reclamar.
Atualizações de servidor, patches de banco de dados e manutenção de infraestrutura são o tipo de trabalho que é invisível quando acontece e caro quando não acontece. Entregue isso a uma plataforma, e mantenha os logs na dashboard, onde você consegue de fato lê-los quando algo quebra.
9. Ficar preso à ferramenta
Seu backend vive dentro da ferramenta que gerou o app. Você não consegue exportá-lo, o preço tem surpresas, e um usuário curioso batendo num endpoint de modelo de linguagem pode esvaziar sua conta numa tarde.
Três perguntas dizem se você está preso. Você consegue baixar todo o seu código? Você sabe quanto vai pagar antes de a conta chegar? Uma chave de API de terceiro que você configurou pode ser gasta por alguém que não é você?
Uma stack open source responde à primeira, preço previsível responde à segunda, e manter as chaves dos provedores no servidor responde à terceira.
8. O muro do backend
O frontend parece pronto. Aí você precisa de login, banco de dados, pagamentos e webhooks, e tudo para. Esse é o momento mais comum em que um projeto morre, porque é quando “quase pronto” se revela “nem começou”.
Um backend gerenciado é exatamente esse muro, já escalado: banco de dados, cadastro e login de usuários, armazenamento de arquivos e APIs REST e GraphQL geradas para você.
Webhooks de pagamento pertencem a uma Cloud Function no servidor, não ao navegador. Um handler de webhook em código de frontend é um handler que qualquer um pode chamar com o payload que quiser.
7. Colocar no ar
Funciona no preview e quebra em produção. Variáveis de ambiente faltando, um 404 ao recarregar a página, um domínio próprio que não conecta, um login que redireciona para localhost.
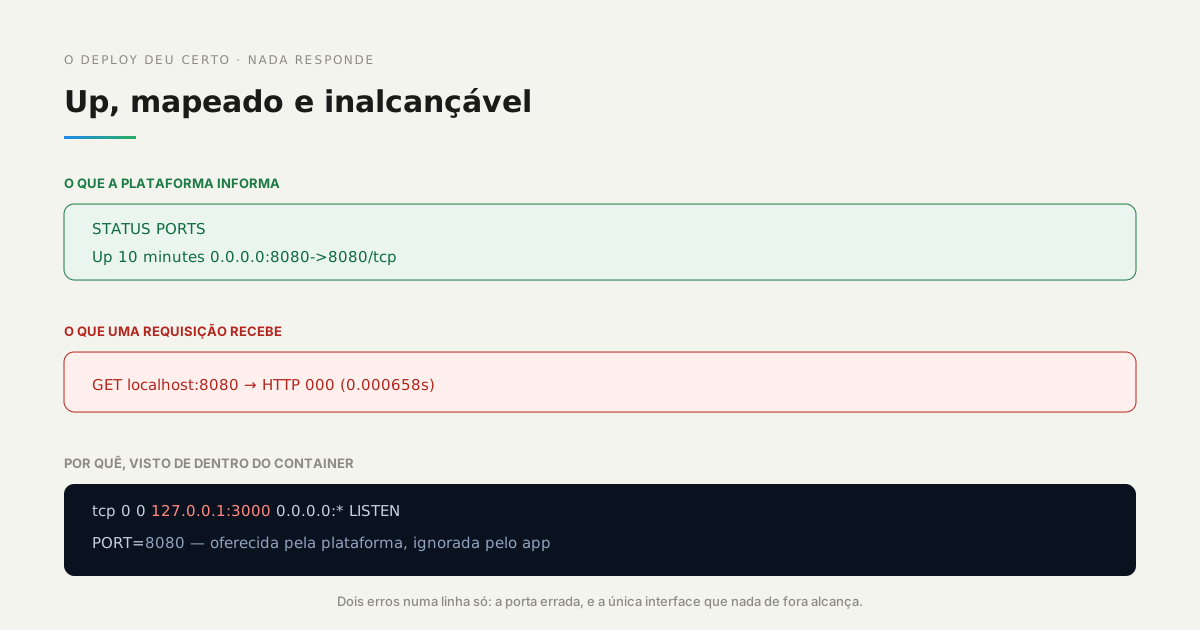
Construímos um desses de propósito para ver como ele fica visto de fora. Um container informando Up, com a porta publicada, devolveu HTTP 000 a cada uma das requisições.
Dentro dele, o app escutava em 127.0.0.1:3000 enquanto a plataforma tinha passado PORT=8080: a porta errada, e a única interface que nada fora do container alcança. Nenhum dos dois é bug num laptop, onde você é o loopback.
Como medimos: o container foi construído a partir de um app gerado por IA, sem modificação, rodado com PORT=8080 e a porta publicada, depois sondado do host com curl, com o socket de escuta lido por dentro com netstat. A execução completa está no post sobre deploy.
6. Não saber o que você não sabe
Para quem não é desenvolvedor, este é o problema número um: quase metade de tudo com que essas pessoas penam. Você não consegue pesquisar o nome de uma coisa de que nunca ouviu falar, e a IA não vai avisar por conta própria que seu app não tem o conceito de permissões.
A defesa é um sistema que você consegue abrir e inspecionar, em vez de uma caixa-preta. Quando um agente constrói as telas, o modelo de dados, as permissões e as funções de servidor, você quer poder olhar cada um deles depois e perguntar o que ele fez.
Essa é a diferença entre uma ferramenta que gerou algo e uma ferramenta que gerou algo que você consegue auditar. Tudo nesta contagem abaixo do número seis é algo que você não sabia que precisava perguntar.
Ninguém escreve um post sobre a vulnerabilidade que não sabe que colocou no ar.
5. A própria plataforma quebra
Quedas, modos congelados, contas desativadas, suporte que nunca responde. Se o seu app vive dentro da ferramenta que o gerou, o dia ruim da ferramenta é o dia ruim do seu app.
A solução estrutural é separar o lugar onde você constrói do lugar onde o app roda. Seus dados e seu backend ficam numa infraestrutura feita para produção; o ambiente de desenvolvimento é só onde você trabalha.
Aí uma queda na ferramenta com que você constrói é um incômodo para você e invisível para os seus usuários.
4. O ciclo vicioso
Você conserta uma coisa, a IA quebra outras duas, e bugs que você matou semana passada voltam. É o doom loop. Ninguém resolveu isso, e nenhuma plataforma consegue impedir um modelo de entrar em loop.
O que mais encontramos não foi um erro, foi silêncio. Em um build, o código de integração gerado chamava uma API que tinha sido removida duas versões major antes, e a falha era engolida por um bloco catch, então a funcionalidade simplesmente não fazia nada.
Duas coisas tornam o loop sobrevivível. Versionamento pelo qual você consegue voltar passo a passo, para que uma rodada ruim seja um revert, não uma escavação. E não pagar duas vezes: se você pede a um agente para consertar algo que ele quebrou, essa correção deveria ser por conta da plataforma, não dos seus créditos.
3. O preço da própria IA
Este é o problema de que as pessoas mais reclamam, entre todos os treze. Os créditos somem, os limites são atingidos em dias, e você acaba pagando a IA para consertar os bugs que a IA criou.
A maior parte desse gasto não vai para o seu produto. Vai para pedir a um modelo que conecte banco de dados, autenticação e servidor, as partes que são idênticas em todo aplicativo já construído.
Quando a infraestrutura já está lá, esses prompts não acontecem. O agente gasta os tokens na sua interface e na sua lógica, que é a única parte que é de fato sua.
2. Perder seus dados
Agentes de IA já apagaram bancos de dados de produção. Em um caso documentado, um único comentário apagou tudo em nove segundos, e os backups estavam no mesmo disco, então foram junto.
Não é raro. Cerca de um terço das pessoas no estudo sofreu dano real por isso: a taxa mais alta de qualquer item desta lista.
| O que aconteceu | Dados que sobraram |
|---|---|
| Container reiniciado | sobrevivem |
| Container substituído a partir da mesma imagem | somem |
| Container substituído, com um volume | sobrevivem |
Medimos a versão mais silenciosa do mesmo problema. Um deploy não reinicia a sua aplicação, ele a substitui, e a substituição descarta a camada gravável do container. O teste óbvio passa, e é isso que torna o problema caro.
Como medimos: um registro gravado pelo app em execução, depois o container reiniciado, depois removido e recriado a partir da mesma imagem, depois o par repetido com um volume nomeado montado.
Dois hábitos cobrem as duas versões. Backups guardados longe do app, para que o que destrói seus dados não consiga alcançá-los. E apps separados para teste e produção, para que o agente nunca tenha as chaves dos dados reais dos usuários.
1. Segurança
É o número um porque é invisível. Só 1,3% dos vibe coders falam disso, mas 98% dos 1.072 apps feitos com IA que foram escaneados tinham pelo menos uma falha, e 172 deles deixam qualquer um apagar dados sem nem fazer login.
Pesquisadores encontraram mais de 16.000 bancos de dados que qualquer pessoa na internet consegue ler.
Os casos de sempre são os mesmos três: chaves de API paradas no navegador, permissões do banco de dados deixadas abertas, e uma IA que “conserta” um erro de permissão distribuindo acesso de admin.
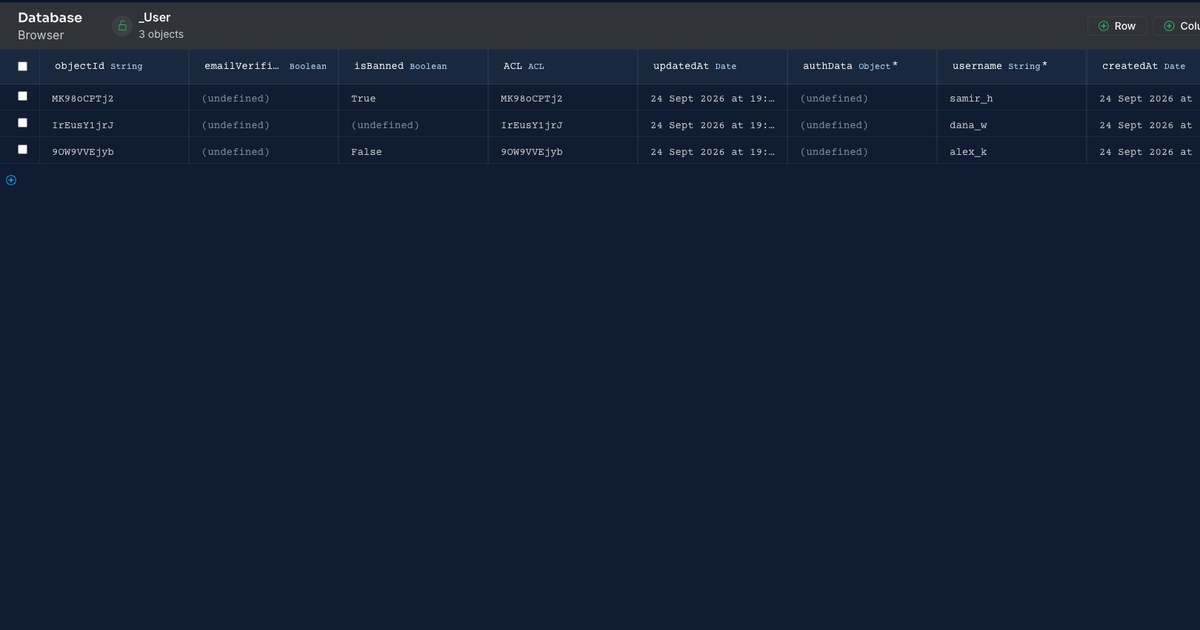
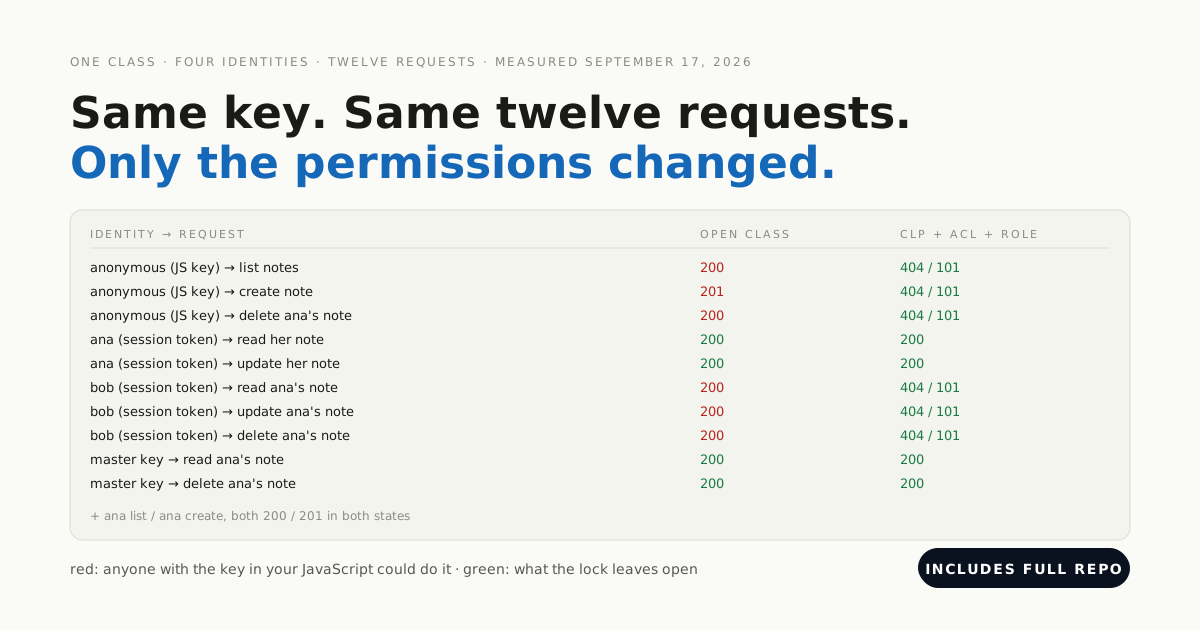
Vimos a forma disso no nosso próprio build de um sistema de banimento. Bloquear o login levou um trigger, mas a conta banida continuava com uma sessão funcionando, e conseguia limpar a própria flag de banida, porque nada no framework tinha opinião sobre nenhuma das duas coisas.
Como medimos: requisições feitas só com o App ID e a REST key, nunca com a master key, porque a master key ignora as regras que um teste deveria exercitar. A execução está no post sobre banimento.
A solução é que as permissões sejam aplicadas no servidor. Listas de controle de acesso decidem quem pode ler e escrever cada registro individual, e chaves secretas e chamadas de API pagas vivem no Cloud Code, nunca no navegador.
O teste de dois minutos que você pode fazer hoje
Crie uma segunda conta no seu próprio app. Tente ver os dados da primeira.
Se você consegue, qualquer um consegue.
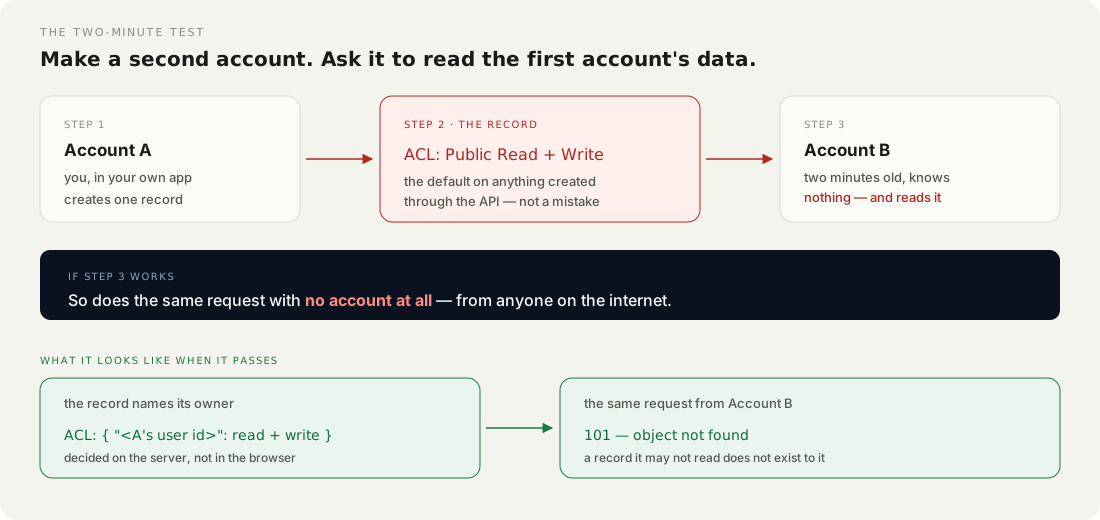
Esse é o teste inteiro, leva dois minutos e pega a única falha que lidera todo estudo de código gerado por IA. Depois faça o mesmo com a aba de rede do navegador aberta e olhe o que as requisições carregam: uma chave de API visível ali é uma chave que qualquer um pode copiar.
Qual desses realmente acaba com o seu app?
Os problemas de 13 a 3 atrasam você e custam dinheiro. Eles se anunciam, frustram você, e essa frustração faz o trabalho dela: você os conserta porque estão no seu caminho.
Os problemas 2 e 1 podem acabar com o app, e nenhum dos dois anuncia nada. Os dados somem antes de você saber que estavam em risco; uma verificação de permissão que falta não produz erro, nem página lenta, nem deploy com falha. Produz uma aplicação que funciona perfeitamente, para todo mundo, inclusive para quem não deveria conseguir chegar nela.
A boa notícia é que eles são também os dois mais fáceis de evitar, e só se você configurar tudo direito desde o primeiro dia. Backups em outro lugar que não o app. Teste separado de produção. Permissões decididas no servidor, e conferidas por uma segunda conta antes que qualquer outra pessoa crie uma.