Você pediu a uma ferramenta de IA um app de notas com resumos por IA, e ela entregou. Ele roda. Você abre no localhost, ele salva notas, parece pronto.
Então você faz o deploy, e a plataforma diz que o container está Up — e nada responde. Sem stack trace, sem log de crash, sem pista. Só um container de aparência saudável e uma requisição que dá timeout.
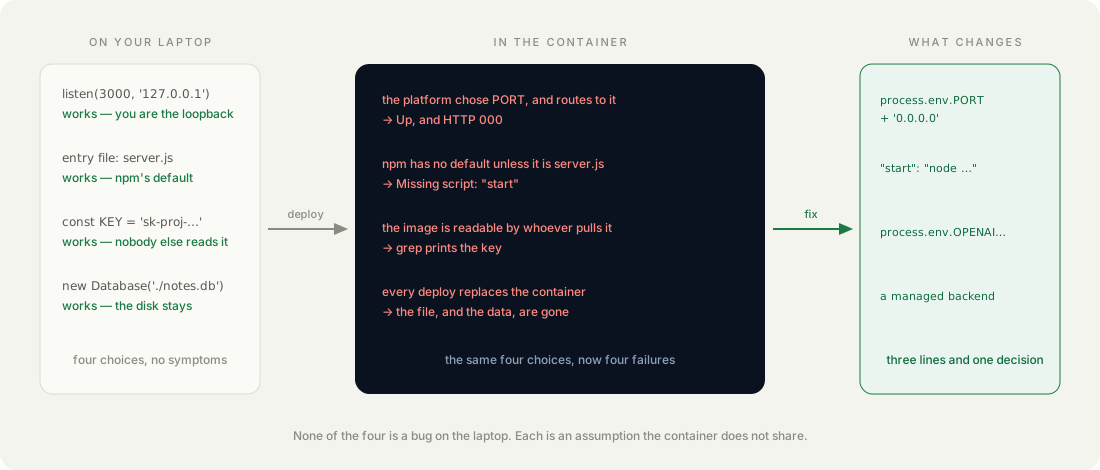
Este guia pega exatamente esse app, reproduz as quatro falhas que o deixaram nesse estado e mostra a saída real de cada uma. Três são uma linha. A quarta é a única que exige que você decida alguma coisa.
Por que um container saudável não responde nada?
Porque “rodando” e “alcançável” são afirmações diferentes, e a plataforma só consegue verificar a primeira. Um container cujo processo não encerrou está Up, seja lá o que esse processo estiver fazendo.
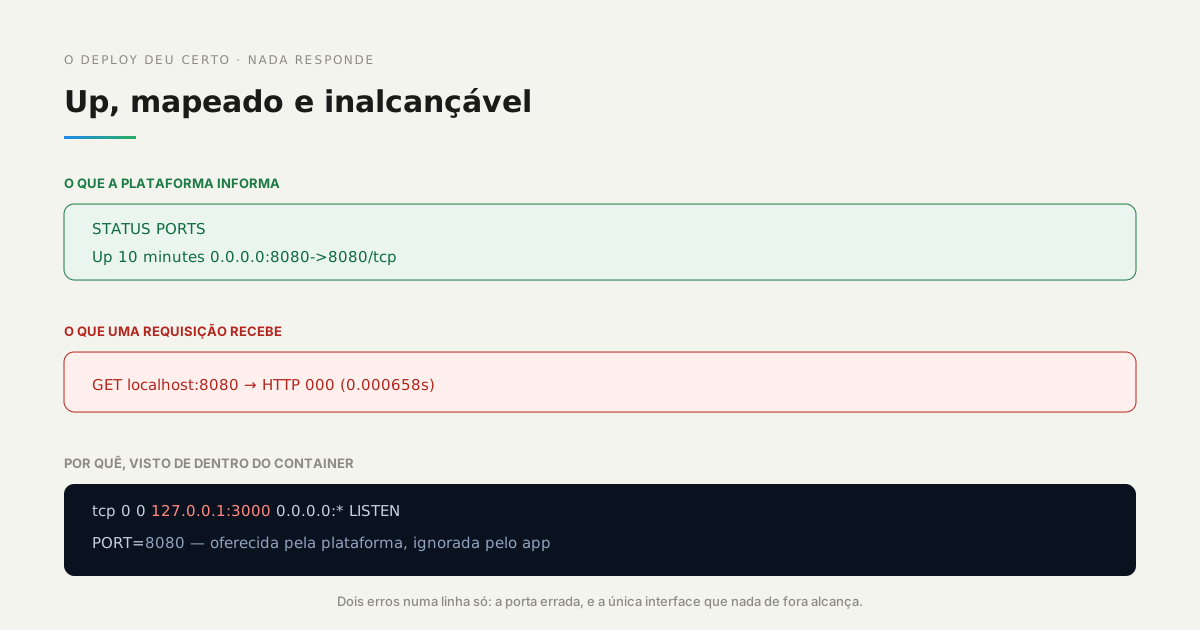
Este é o estado em que o app em deploy realmente estava. Visto de fora, o container parece correto: está rodando, e a porta está mapeada:
STATUS            PORTS
Up 10 minutes     0.0.0.0:8080->8080/tcp
E toda requisição a ele falha:
GET localhost:8080 → HTTP 000 (0.000658s)000 não é um status que o app devolveu. É o curl informando que nada aceitou a conexão. Olhar dentro do container explica o motivo:
netstat -tln | grep LISTEN
tcp   0   0   127.0.0.1:3000   0.0.0.0:*   LISTEN

printenv PORT
8080
A plataforma ofereceu a porta 8080 e o app a ignorou, escutando na 3000. Pior: ele se vinculou a 127.0.0.1, a interface de loopback, então mesmo uma requisição chegando na porta 3000 de fora do container não encontraria nada. Dois erros moram nessa única linha, e o segundo é o que as pessoas deixam passar.
Como medimos: o container foi construído a partir do app sem modificações, rodado com PORT=8080 e a porta publicada, e sondado do host com curl; o socket em escuta foi lido de dentro do container com netstat.
No seu laptop, você é o loopback. Num container, você é a única coisa que não é.
Como fazer o app escutar onde a plataforma está olhando?
Leia a porta do ambiente e vincule todas as interfaces. Uma linha substitui os dois erros:
// Stack: Node 22 + Express 5 | File: server.js
const PORT = process.env.PORT || 3000;
app.listen(PORT, '0.0.0.0', () => console.log(`listening on 0.0.0.0:${PORT}`));
O || 3000 mantém o desenvolvimento local funcionando exatamente como antes, então esta não é uma mudança que você precisa lembrar de desfazer. 0.0.0.0 significa “toda interface que este container tem”, que é o que o torna alcançável de fora dele.
Com essa única linha alterada, o mesmo container responde:
GET /          → HTTP 200
GET /healthz   → HTTP 200
listening on   0.0.0.0:8080
A falta de um script start quebra mesmo o deploy?
Às vezes, e quais vezes é a parte surpreendente. O npm traz um script start padrão, e se você se beneficia dele ou não depende do nome do seu arquivo de entrada.
Este package.json não tem script start nenhum:
{
  "scripts": { "dev": "node server.js" }
}
Rode npm start contra ele duas vezes, mudando só o nome do arquivo:
entry = server.js   →   the app starts
entry = app.js      →   npm error Missing script: "start"
O npm substitui por node server.js quando existe um arquivo com esse nome, e por nada caso contrário. Então o mesmo script ausente é inofensivo num projeto e fatal no seguinte, decidido por uma escolha de nome que a ferramenta de IA fez por você.
Como medimos: dois diretórios com o package.json idêntico, diferindo apenas em o arquivo de entrada ser server.js ou app.js, cada um rodado com npm start num container node:22-alpine limpo.
{
  "scripts": {
    "dev": "node server.js",
    "start": "node server.js"
  }
}
O que acontece com uma chave que você colou no código?
Ela vai junto. Uma chave num arquivo-fonte está na imagem, e qualquer pessoa que consiga baixar a imagem consegue lê-la sem iniciar nada:
docker run --rm notes-app grep -n "sk-proj" server.js
11:const OPENAI_API_KEY = 'sk-proj-REDACTED-this-was-pasted-into-the-file';
Sem app rodando, sem requisição de rede, sem acesso à sua conta: só a imagem e um comando. Ela também está no seu histórico do git desde o primeiro commit, o que sobrevive a qualquer remoção posterior da linha.
A correção é a linha que a ferramenta de IA deveria ter escrito desde o início, mais definir o valor onde a plataforma guarda as variáveis de ambiente:
const OPENAI_API_KEY = process.env.OPENAI_API_KEY;Depois dessa mudança, o mesmo grep não devolve nada, enquanto o app em execução continua informando a chave como configurada: ela está presente em tempo de execução e ausente do artefato.
Como medimos: grep -c "sk-" contra a cópia de server.js na própria imagem devolveu 0, e a resposta / do próprio app informou keyConfigured: true com o valor fornecido como variável de ambiente.
Por que as notas sumiram, e por que não ao reiniciar?
Porque um deploy não reinicia o seu container: ele o substitui. Esta é a falha que mais custa tempo às pessoas, porque o teste óbvio passa.
O app gravava as notas num arquivo dentro do container. Três rodadas da mesma verificação, com uma nota salva:
| O que aconteceu | Notas restantes |
|---|---|
docker restart | 1 — sobrevive |
| Container substituído a partir da mesma imagem | 0 — sumiu |
| Container substituído, com um volume montado | 1 — sobrevive |
Um restart mantém a camada gravável do próprio container, então o arquivo continua lá e o armazenamento parece persistente. A substituição descarta essa camada.
As plataformas substituem o container a cada deploy, a cada evento de escala e a cada migração de host, o que significa que os dados nunca estiveram seguros: o teste de restart simplesmente nunca fez a pergunta certa.
Como medimos: uma nota postada pelo app, depois o container reiniciado, depois removido e recriado a partir da mesma imagem, depois o par repetido com um volume nomeado montado no diretório do app.
Onde os dados devem ficar, afinal?
Fora do container, em algo cujo trabalho é continuar existindo amanhã. Um volume é a resposta menor e funciona, mas amarra os dados a um host e deixa backups, migrações e acesso concorrente por sua conta.
A versão no repositório companion envia as notas para um backend gerenciado, de modo que o container não guarda estado nenhum:
// Stack: Node 22 | File: server.js
const PARSE = 'https://parseapi.back4app.com';
const parseHeaders = {
  'X-Parse-Application-Id': process.env.PARSE_APP_ID,
  'X-Parse-REST-API-Key': process.env.PARSE_REST_KEY,
  'Content-Type': 'application/json',
};
Depois, o mesmo teste destrutivo que antes perdeu tudo:
note posted            →  1 note
container replaced     →  1 note
O container ficou descartável, que é o que você queria dele desde o começo. Repare que as credenciais chegam do mesmo jeito que a API key chega agora: as duas correções são o mesmo hábito aplicado duas vezes.
Quais erros dizem qual falha você tem?
Quase nenhum, e é por isso que este guia começa pelos sintomas. As quatro falhas produzem quase nenhuma saída de diagnóstico, e essa é a característica que as define.
| O que você vê | Qual falha |
|---|---|
Container Up, requisições devolvem HTTP 000 ou dão timeout | porta errada, ou vinculado a 127.0.0.1 |
npm error Missing script: "start" no log do deploy | sem script start, arquivo de entrada não é server.js |
| Nada — funciona | a chave está na imagem, e vai continuar até alguém encontrá-la |
| Dados corretos depois de um restart, vazios depois de um deploy | estado no filesystem do container |
Só a segunda se anuncia. A primeira parece um problema de rede, a terceira parece sucesso e a quarta parece um bug de restart. Se o log do seu deploy está vazio e o seu app está inalcançável, comece pelo endereço de escuta antes de suspeitar da plataforma.
Quando um container é o lugar errado para este app?
Quando o que você está colocando em deploy não contém servidor nenhum. Um app de página única sem nada por trás é uma pilha de arquivos estáticos, e embrulhá-lo em Node para servi-los compra um processo para supervisionar e nada mais: sirva os arquivos diretamente.
Também é o formato errado quando o trabalho é um agendamento, e não uma requisição. Um relatório noturno não precisa de algo escutando numa porta; precisa de algo que roda e encerra, e um container mantido aberto por um servidor web se encaixa mal nisso.
E se o seu app precisa de verdade de um disco local gravável (um conversor de imagens trabalhando com arquivos temporários grandes, digamos), um container serve, mas planeje para o disco estar vazio a cada início. Isso é uma restrição para projetar em torno, não um bug para corrigir depois.
O que você acrescentaria ao deploy-failure lab em seguida?
Um endpoint de health check que falhe com honestidade. O /healthz do repositório devolve { "ok": true } incondicionalmente, o mesmo otimismo que a plataforma mostrou ao chamar de Up o container quebrado; apontá-lo para o backend de que o app depende faria com que ele significasse alguma coisa.
Depois disso, uma verificação em tempo de build. Três dessas quatro falhas são visíveis no código-fonte antes de qualquer deploy: uma porta fixa no código, um script start ausente, uma string começando com sk-. Um script curto no CI que recuse o build as pegaria mais cedo do que qualquer log de deploy.