Você tem um script que precisa ficar acordado o tempo todo. Um bot que espera mensagens, um webhook que precisa responder em menos de dez segundos, um job que roda a cada minuto. E toda página de hospedagem oferece uma de duas opções que não servem: uma função que morre entre requisições, ou uma máquina Linux que agora você precisa manter atualizada.
Esta é a distinção que faz o resto do post fazer sentido. Um request handler roda quando alguém o chama. Um processo sempre ativo roda porque existe — timers, loops e sockets abertos precisam disso. O segundo tipo é o motivo de as pessoas alugarem um VPS, e é o tipo que uma plataforma de containers pode rodar para você, se ela mantiver o container vivo.
Os outros três posts sobre containers tratam de apps dirigidos por requisição (um app web em Node, um serviço FastAPI, uma página Next.js com SSR).
Este post trata do processo que precisa continuar de pé entre as requisições.
Escrevemos um processo Node de 75 linhas que faz os três trabalhos — um receptor de webhook assinado no estilo do GitHub, um tick de cron a cada 60 segundos, um worker de fila a cada 5 segundos — com todo o estado em um backend gerenciado.
Fizemos o deploy, medimos, vimos o plano Free matá-lo depois de exatamente uma hora e o movemos para um plano de US$ 5/mês, onde ele escreve um heartbeat por minuto desde então. Tudo abaixo vem dessa execução, em 15 e 16 de setembro de 2026.
Pegue o código funcionando: o repositório companion está em github.com/templates-back4app/always-on-worker — server.js, Dockerfile, cloud/main.js e deploy-check.sh, que dispara um webhook assinado e um sem assinatura contra um deployment e confere as duas respostas.
O que “sempre ativo” exige de verdade?
Três coisas, e a maioria das páginas de hospedagem só menciona a primeira: um processo que não é parado entre requisições, uma URL HTTPS pública para os webhooks baterem e um lugar para o estado viver que não seja o processo. Pule a terceira e cada restart apaga a sua fila.
| O que o trabalho precisa | Por que um request handler não dá conta | Onde fica neste post |
|---|---|---|
| Um timer que dispara a cada minuto | Nada chama um handler às 03:00 | Container, tick de cron |
| Um loop que consulta uma fila a cada 5 s | Handlers não têm “entre requisições” | Container, loop do worker |
| Uma URL que responde webhooks em segundos | Cold starts consomem o timeout de entrega | Container, /webhook |
| Estado que sobrevive ao processo | O container é descartável | Backend, três classes |
| Um jeito de saber que ele ficou mesmo no ar | “Deve estar rodando” não é métrica | Backend, contagem de heartbeats |
A resposta clássica é um VPS: uma máquina de US$ 5, cron, pm2, e agora você é a pessoa que aplica patch no OpenSSL. A resposta serverless cobre o webhook e, com um scheduler, o timer — mas não o loop, nem o socket aberto que um bot mantém. Um container que a plataforma mantém vivo cobre as cinco linhas sem os patches.
A Back4app é a que testamos porque as duas metades vêm de uma só conta: um app de backend com banco de dados gerenciado e hooks, e um app de container que roda o Dockerfile e, em um plano pago, o mantém rodando. O resto deste post é o passo a passo medido pelos dois.
Um processo que precisa estar acordado entre eventos é o motivo inteiro de as pessoas alugarem servidores. Essa é a única parte que vale a pena pagar.
O que roda dentro do container sempre ativo?
Um processo Express com três trabalhos que não compartilham nada além do backend. POST /webhook verifica uma assinatura HMAC no estilo do GitHub e guarda o evento. Um setInterval escreve um Heartbeat a cada 60 segundos — conte-os depois e você tem o uptime real. Um segundo intervalo pega o Job pendente mais antigo a cada 5 segundos e o conclui.
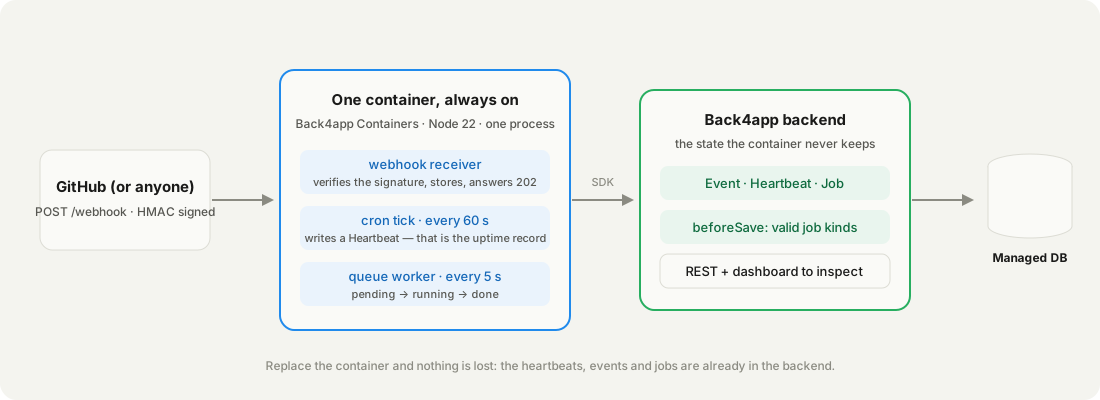
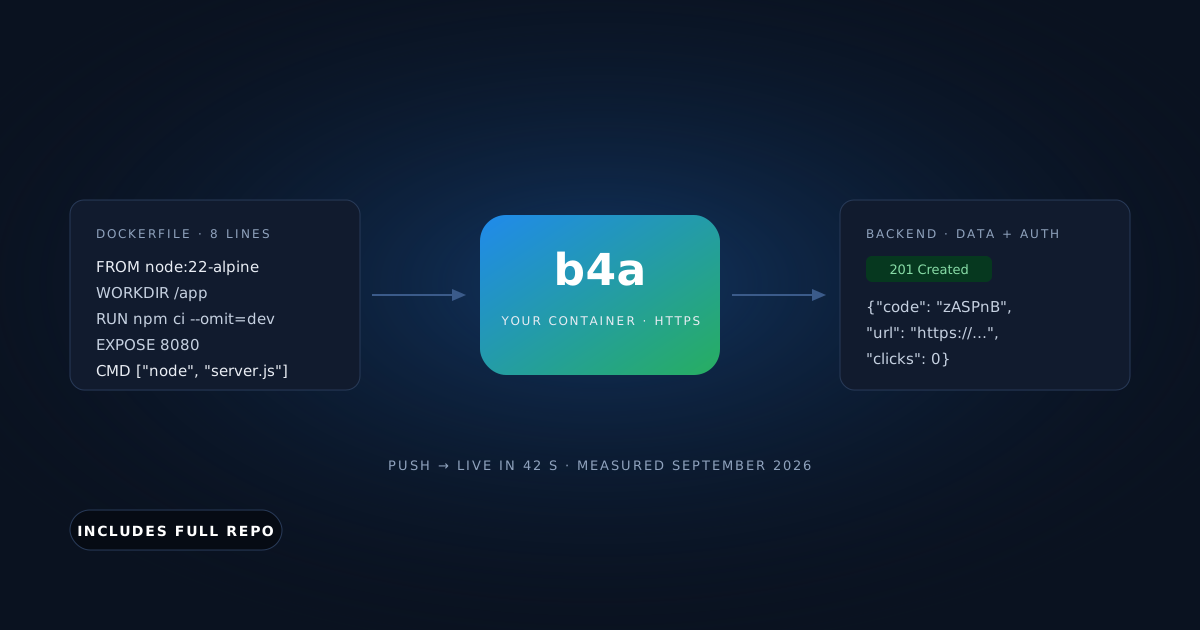
O Dockerfile inteiro tem oito linhas. A plataforma lê a porta do EXPOSE:
# Stack: Docker | Node.js 22 (alpine) | File: Dockerfile
FROM node:22-alpine
WORKDIR /app
COPY package*.json ./
RUN npm ci --omit=dev
COPY . .
ENV NODE_ENV=production
EXPOSE 8080
CMD ["node", "server.js"]
A rota de webhook é a parte que as pessoas erram. Ela precisa do body bruto para a assinatura, de uma comparação em tempo constante e de uma resposta rápida — guarde primeiro, trabalhe depois:
// Stack: Node.js 22.x | Express 5.x + Parse JS SDK 8.x | File: server.js (webhook)
app.use(express.json({ verify: (req, _res, buf) => { req.rawBody = buf; } }));

app.post("/webhook", async (req, res) => {
  const sig = req.get("x-hub-signature-256") ?? "";
  const expected = "sha256=" + createHmac("sha256", WEBHOOK_SECRET).update(req.rawBody).digest("hex");
  if (!WEBHOOK_SECRET || sig.length !== expected.length || !timingSafeEqual(Buffer.from(sig), Buffer.from(expected))) {
    return res.status(401).json({ error: "bad signature" });
  }
  const ev = new Parse.Object("Event");
  ev.set("source", req.get("x-github-event") ?? "unknown");
  ev.set("payload", req.body);
  await ev.save();
  res.status(202).json({ stored: ev.id });
});
O cron e o worker são dois timers. Nenhum dos dois guarda em memória nada que importe:
// Stack: Node.js 22.x | Express 5.x + Parse JS SDK 8.x | File: server.js (cron + queue)
setInterval(async () => {                       // 1. cron: a heartbeat every minute
  const hb = new Parse.Object("Heartbeat");
  hb.set("at", new Date()); hb.set("up_s", Math.round((Date.now() - startedAt) / 1000));
  await hb.save();
}, 60_000);

setInterval(async () => {                       // 2. queue: oldest pending Job, every 5 s
  const job = await new Parse.Query("Job").equalTo("status", "pending").ascending("createdAt").first();
  if (!job) return;
  job.set("status", "running"); await job.save();
  const t0 = Date.now();
  const result = await runJob(job.get("kind"), job.get("input"));
  job.set("status", "done"); job.set("result", result); job.set("ms", Date.now() - t0);
  await job.save();
}, 5_000);Você precisa de uma conta gratuita na Back4app, uma conta no GitHub, curl e openssl. Nada de Docker na sua máquina: a plataforma faz o build da imagem, e este post foi produzido em um Mac sem Docker instalado.
Para onde vai o estado?
Para um app de backend — três classes que o container cria na primeira escrita, e uma regra que o container não consegue burlar. Dashboard → New App → Build your Backend, dê um nome, Create; a página Overview mostra o App ID e, no dropdown Keys, a JavaScript key. Esses dois valores são a única configuração de que o container precisa.
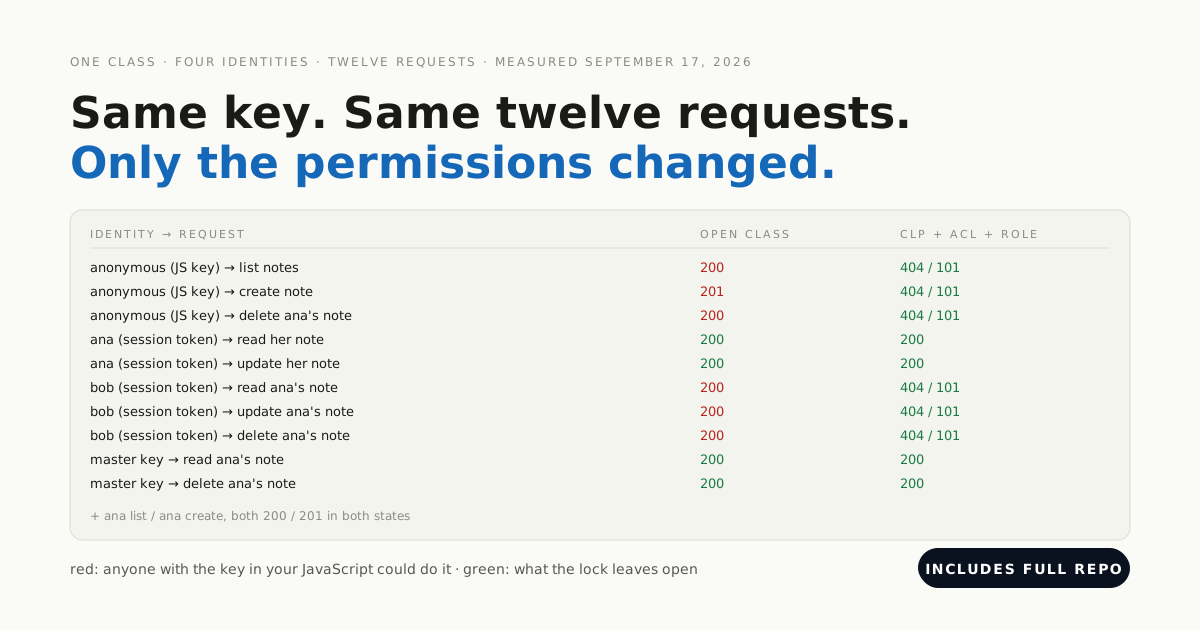
A JavaScript key que o container envia é uma chave de cliente: o que ela pode fazer é decidido pelas permissões da classe, que medimos trava por trava em outro post.
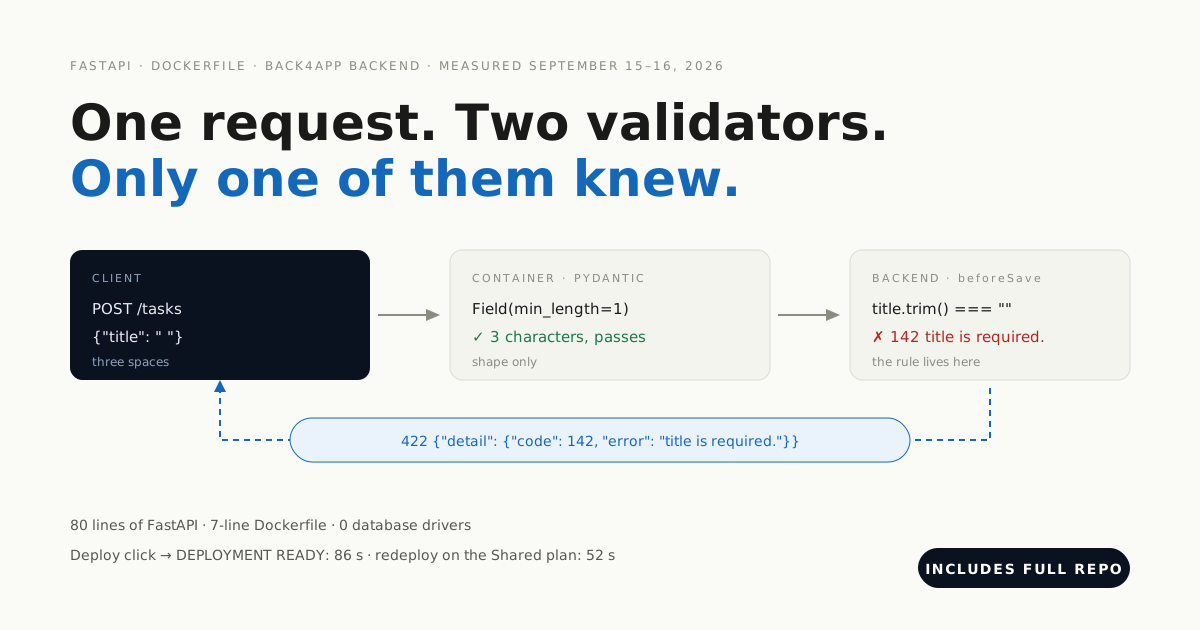
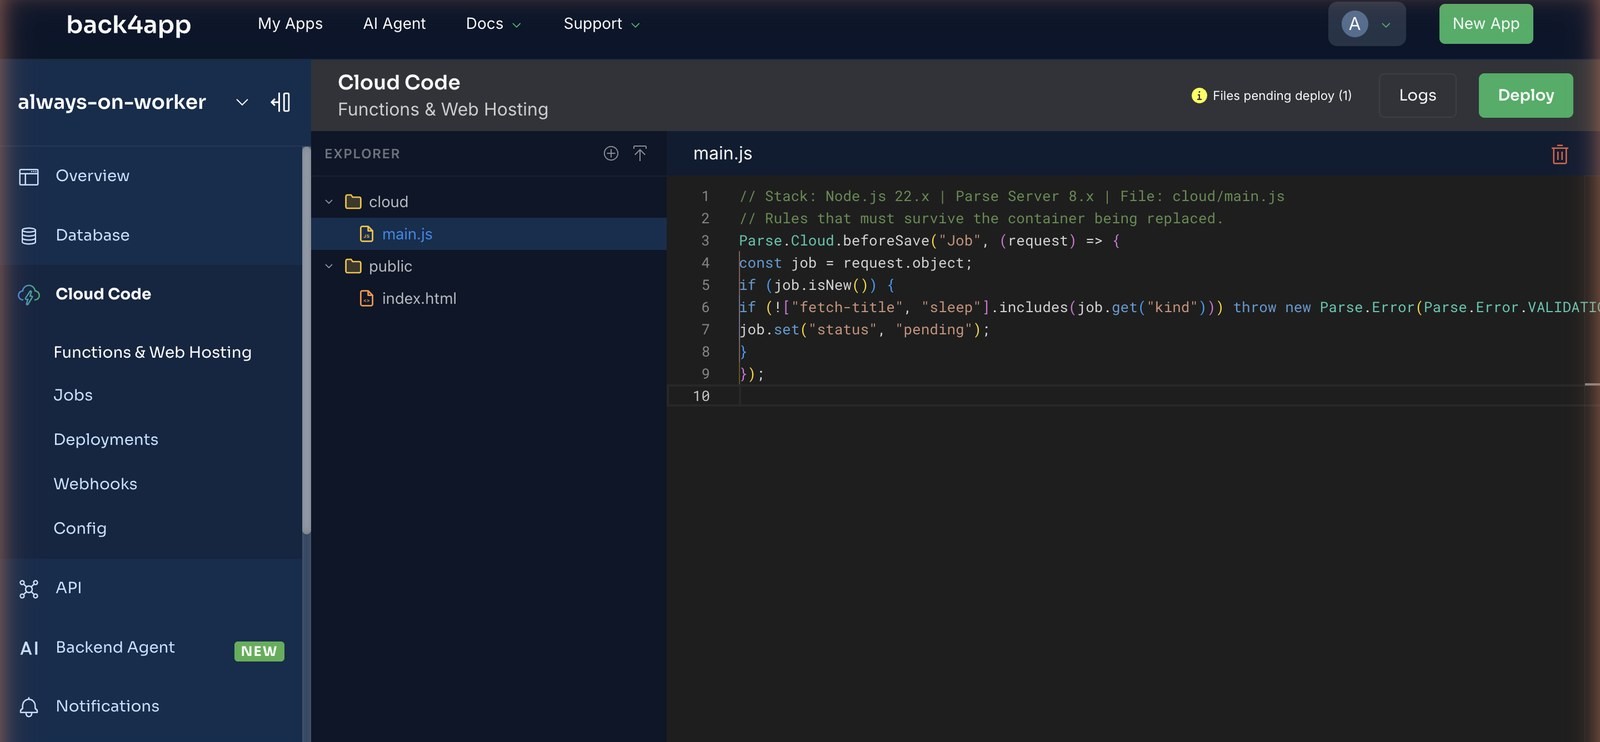
A única regra vive no Cloud Code, dentro do backend. Qualquer coisa pode criar um Job — um curl, outro serviço, o AI Agent — e o hook decide o que é um job válido. Um job com um kind que o worker não conhece nunca chega à fila:
// Stack: Node.js 22.x | Parse Server 8.x | File: cloud/main.js
Parse.Cloud.beforeSave("Job", (request) => {
  const job = request.object;
  if (job.isNew()) {
    if (!["fetch-title", "sleep"].includes(job.get("kind")))
      throw new Parse.Error(Parse.Error.VALIDATION_ERROR, "unknown job kind.");
    job.set("status", "pending");
  }
});
Cole em Cloud Code → cloud/main.js na dashboard do backend e clique em Deploy. Depois prove com uma requisição — enviamos {"kind":"rm-rf"} e recebemos 400 {"code":142,"error":"unknown job kind."}, e {"kind":"sleep","input":{"ms":1500}} voltou 201 com status já definido como pending pelo hook.
Aqui está um job criado de dois jeitos. O worker nunca se importa com qual deles o criou:
// Stack: Node.js 22.x | Parse JS SDK 8.x | File: any Node process with the App ID and JS key
const job = new Parse.Object("Job");
job.set("kind", "fetch-title");
job.set("input", { url: "https://www.back4app.com/" });
await job.save();               // the hook sets status = "pending"; the worker picks it up within 5 s
# Stack: bash | Endpoint: POST /classes/Job
curl -X POST \
-H "X-Parse-Application-Id: $APP_ID" \
-H "X-Parse-REST-API-Key: $REST_KEY" \
-H "Content-Type: application/json" \
-d '{"kind": "fetch-title", "input": {"url": "https://www.back4app.com/"}}' \
"$BASE/classes/Job"
# {"objectId":"…","createdAt":"…","status":"pending"} ← HTTP 201Mesmo objeto, mesmo hook. A forma REST é o que o SDK envia por baixo dos panos.
Como fazer o deploy de um worker que não tem página web?
Envie o repositório para o GitHub e, no lado de Containers, New App → Deploy from GitHub. Na primeira vez, o GitHub pede para instalar o app Back4app Containers nos repositórios que você escolher; a lista de repositórios na dashboard atualiza no momento em que você termina.
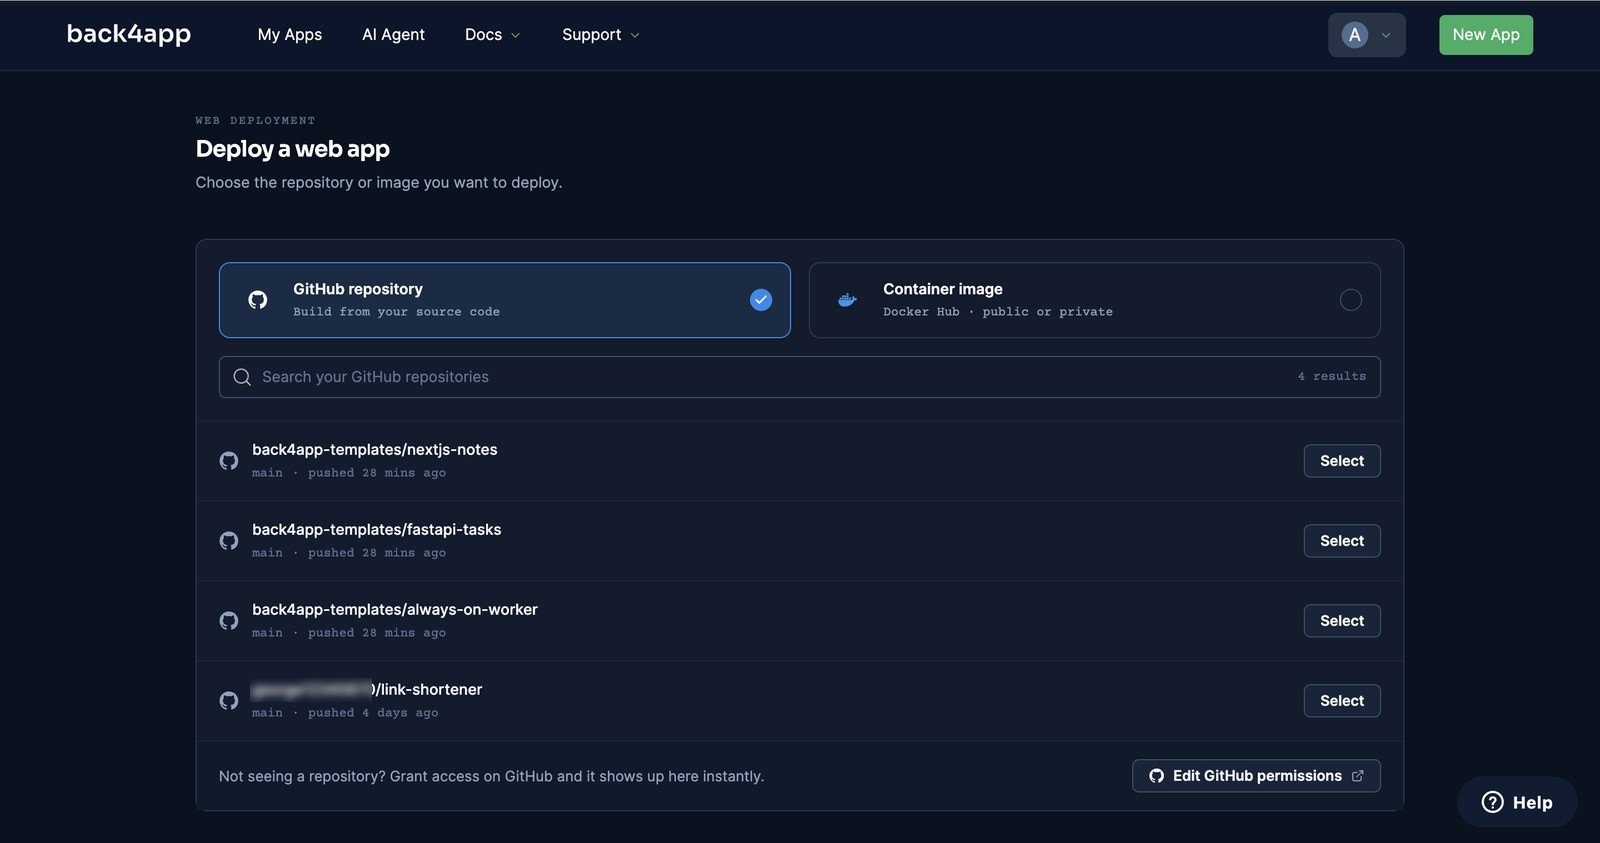
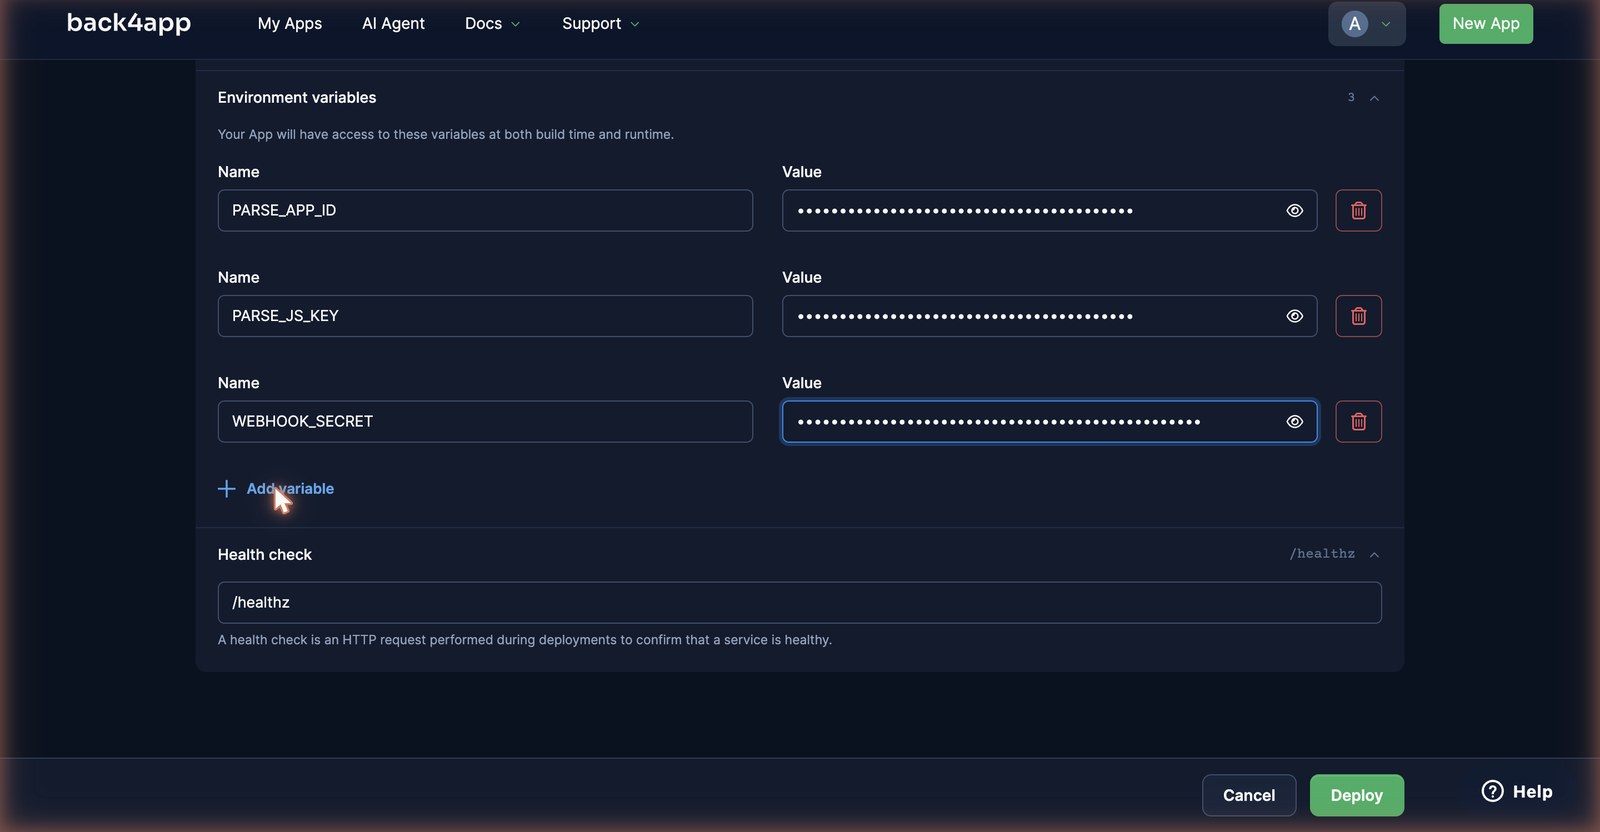
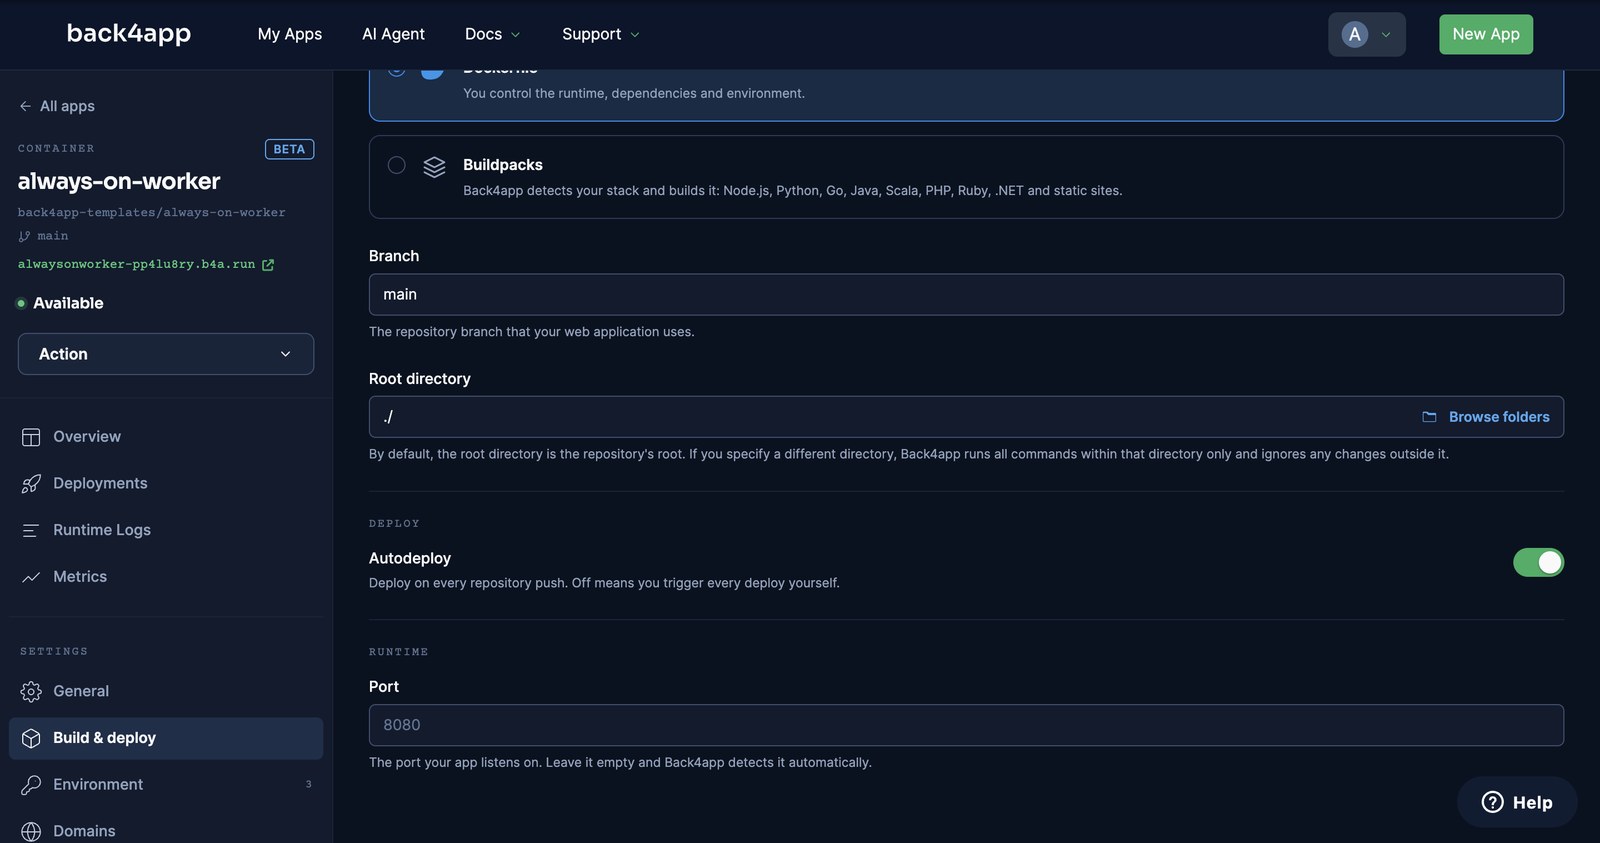
Configure. Selecione o repositório; o formulário detectou o Dockerfile e ofereceu um buildpack Node.js como alternativa. Deixamos a porta em auto (ele lê EXPOSE 8080), adicionamos três variáveis de ambiente — PARSE_APP_ID, PARSE_JS_KEY, WEBHOOK_SECRET — e mudamos o Health check de / para /healthz.
Deploy. Clicamos às 14:55:08. O botão ficou em “Deploying…” por 20 segundos até a página do app aparecer, e então o log correu PREPARING → FETCHING GITHUB REPOSITORY → BUILDING IMAGE → LAUNCHING CONTAINER → CHECKING HEALTH → DEPLOYMENT READY às 14:56:05. Às 14:56:11, /healthz já respondia com o número da versão.
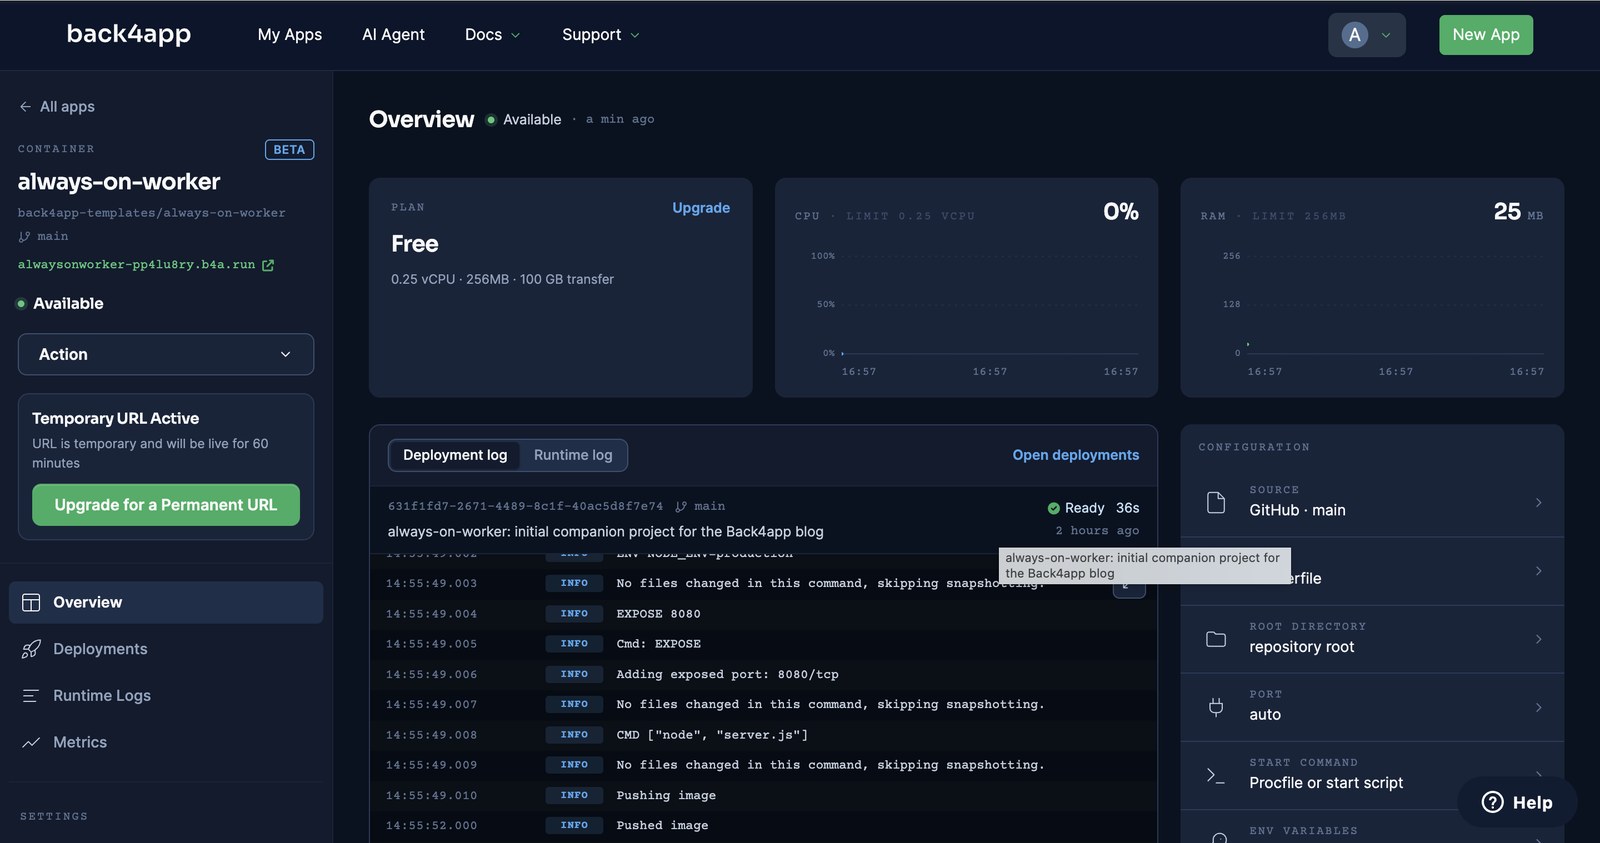
Como medimos: um cronômetro do clique em Deploy até DEPLOYMENT READY, plano Free, um deploy em 15 de setembro de 2026. O tempo de push até o ar é um push com autodeploy ligado, no plano Shared, no dia seguinte, observado por um loop consultando /healthz em busca da nova string de versão.
O deploy-check.sh do repositório faz o que você faria à mão: um POST /webhook assinado (202 {"stored":"…"}), o mesmo body sem assinatura (401), depois /stats. Um Job criado pela REST API às 14:56:38.6 foi pego e concluído às 14:56:41.4 — o loop de 5 segundos funcionou no primeiro tick.
# Stack: bash | File: deploy-check.sh (the signed call)
BODY='{"action":"opened","number":1}'
SIG="sha256=$(printf '%s' "$BODY" | openssl dgst -sha256 -hmac "$WEBHOOK_SECRET" | sed 's/^.* //')"
curl -X POST -H "Content-Type: application/json" -H "X-GitHub-Event: pull_request" \
     -H "X-Hub-Signature-256: $SIG" -d "$BODY" "https://alwaysonworker-<id>.b4a.run/webhook"
# {"stored":"…"}  ← HTTP 202
Como os heartbeats e os jobs aparecem no banco de dados?
Três telas na dashboard do backend, e toda linha nelas foi escrita pelo container acima — sem dados de seed, sem schema definido à mão. Esta é a metade de “sem servidores para administrar” que o container nunca mostra para você.
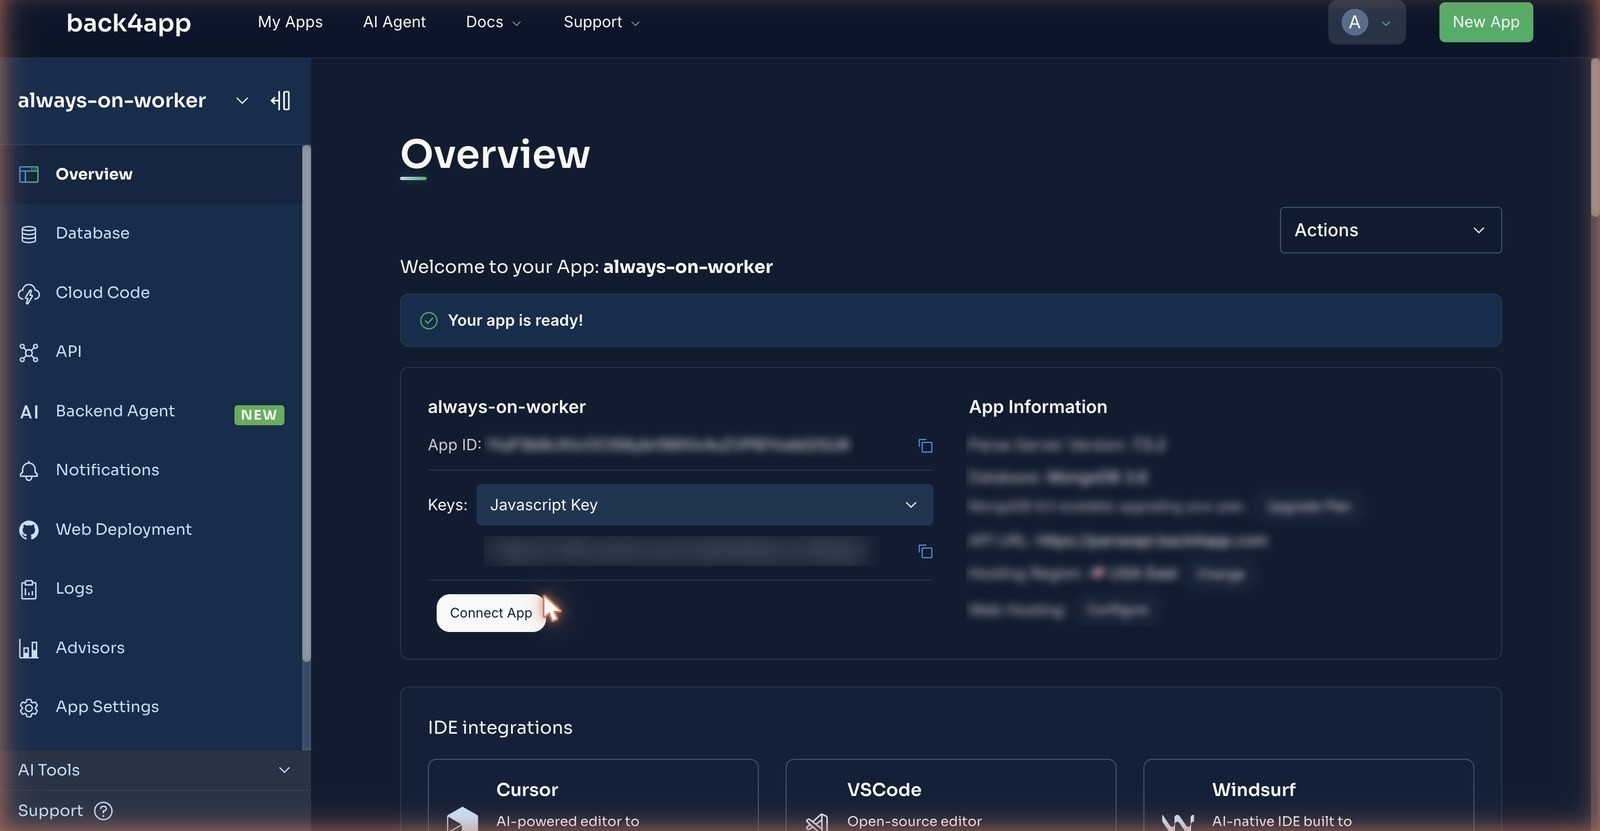
Overview — de onde vêm as duas variáveis. Dashboard → New App → Build your Backend → Create. A página Overview mostra o App ID e, no dropdown Keys, a JavaScript key que o worker usa. Esses são PARSE_APP_ID e PARSE_JS_KEY no formulário do container, e nada mais sobre o banco de dados existe do lado do container.
Cloud Code — onde a regra vive. cloud/main.js aberto no editor, com o hook beforeSave("Job") da seção anterior. O badge no topo, Files pending deploy (1), é o que merece atenção: em um backend novo ele fica em (2) depois do primeiro Deploy, e é assim que você sabe que nada foi enviado.
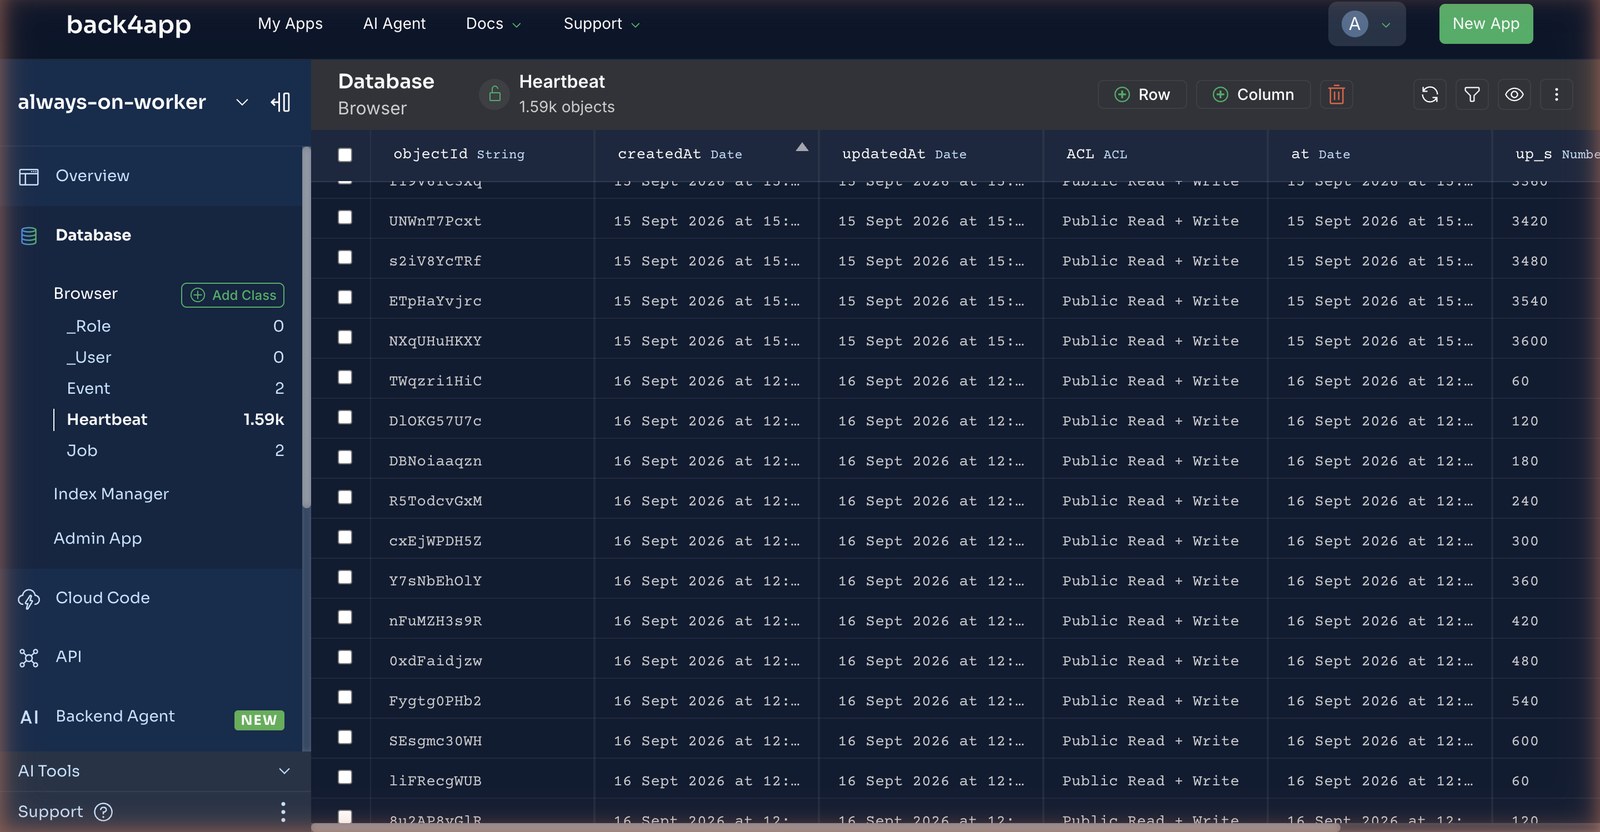
Database Browser — a classe Heartbeat, ordenada por createdAt. O container criou essa classe com o primeiro save; as colunas at e up_s foram inferidas do JSON. As linhas 60 e 61 ficam lado a lado: up_s 3600 em 15 de setembro, depois up_s 60 em 16 de setembro — o intervalo de 20 horas em que o container gratuito não existiu.
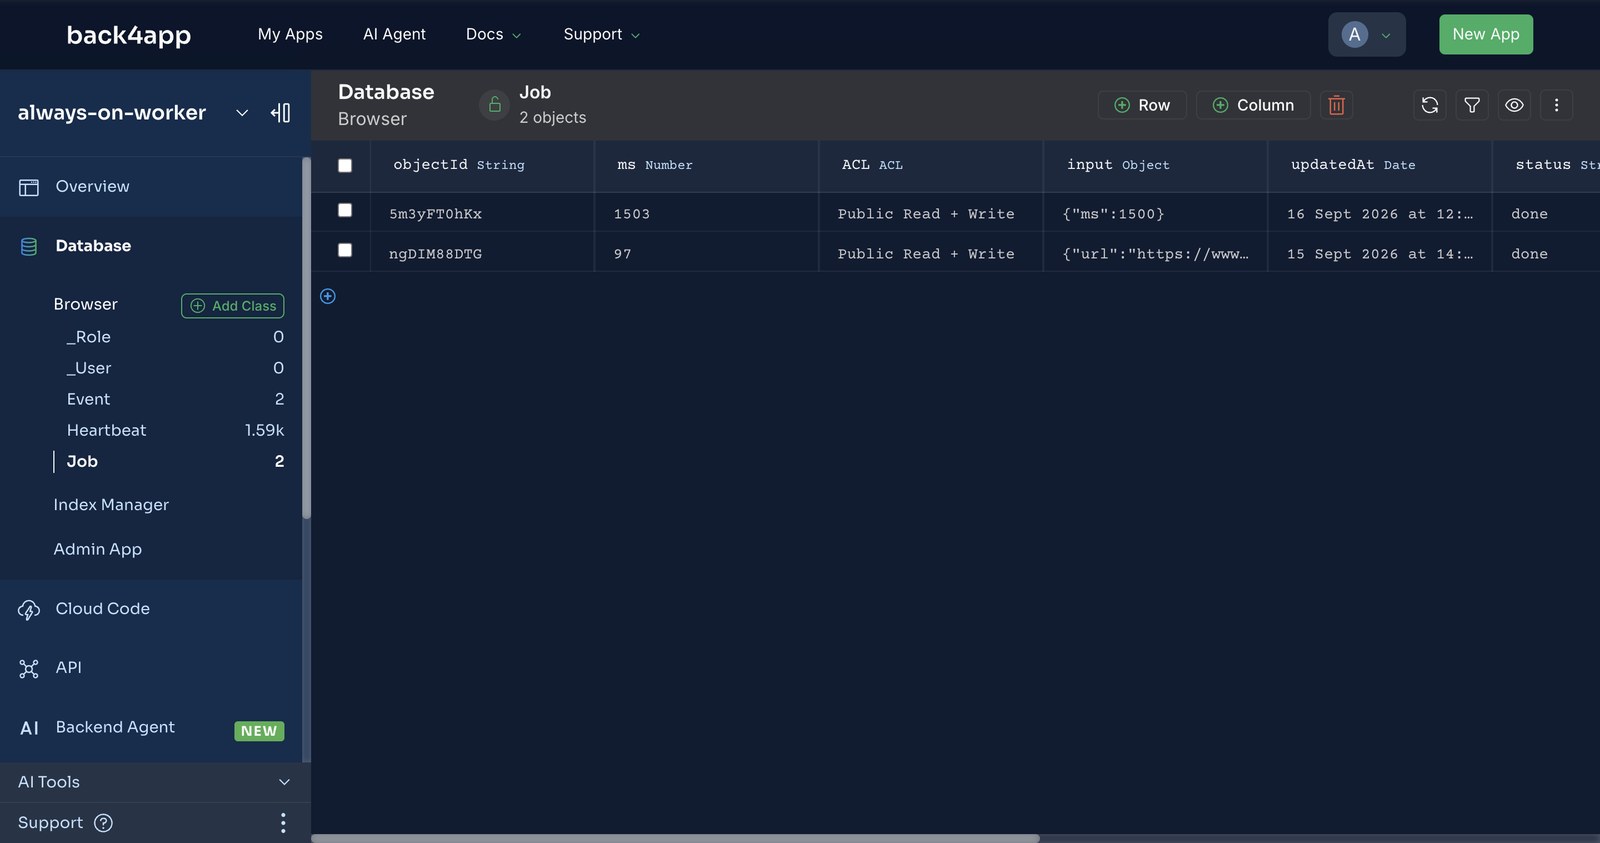
Database Browser — a classe Job. Dois jobs, ambos done: o job fetch-title que a chamada REST criou (ms 97) e um job sleep (ms 1503). O worker escreveu status, result e ms; o hook escreveu o pending inicial; quem chamou escreveu só kind e input.
Por quanto tempo o plano Free mantém o worker rodando?
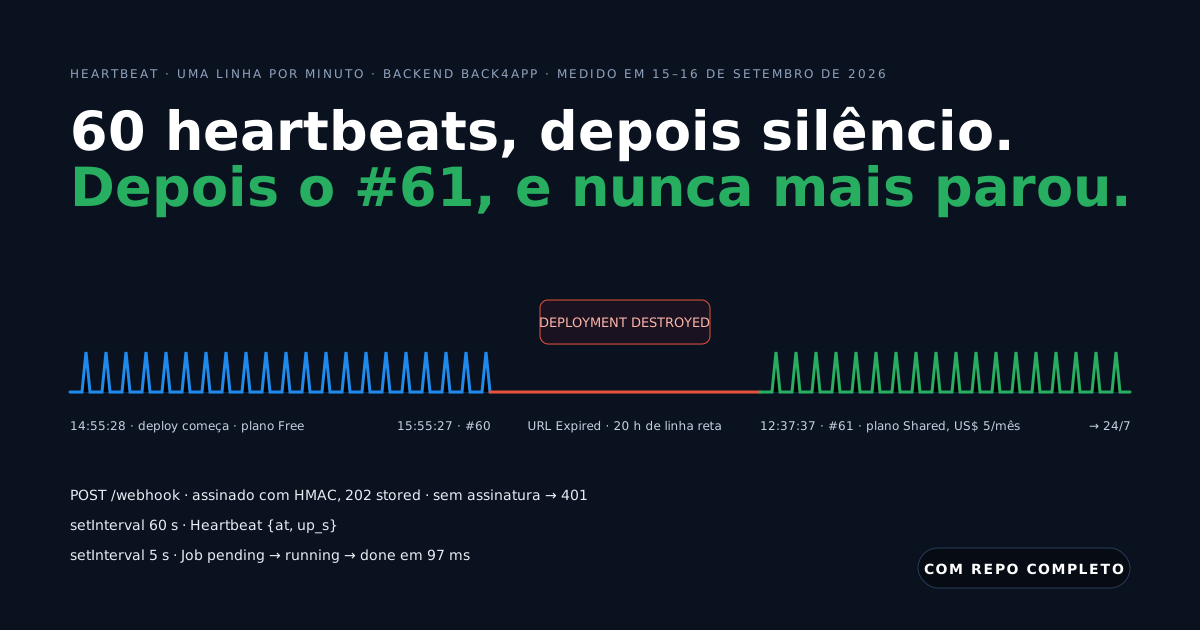
Sessenta minutos, contados do momento em que o deploy começa — e então o container é destruído, não pausado. Este é o achado que muda o formato do post, então aqui está exatamente o que vimos em 15 de setembro de 2026.
O Overview mostrou um card no instante em que o app subiu: Temporary URL Active — URL is temporary and will be live for 60 minutes. Tínhamos um poller em /healthz e na contagem de heartbeats do backend, uma vez por minuto.
O deploy começou às 14:55:28. Às 15:55:27 a URL respondeu 404 not found. O backend tinha exatamente 60 heartbeats e nunca recebeu o 61º — o timer dentro do container tinha parado, porque o container tinha parado.
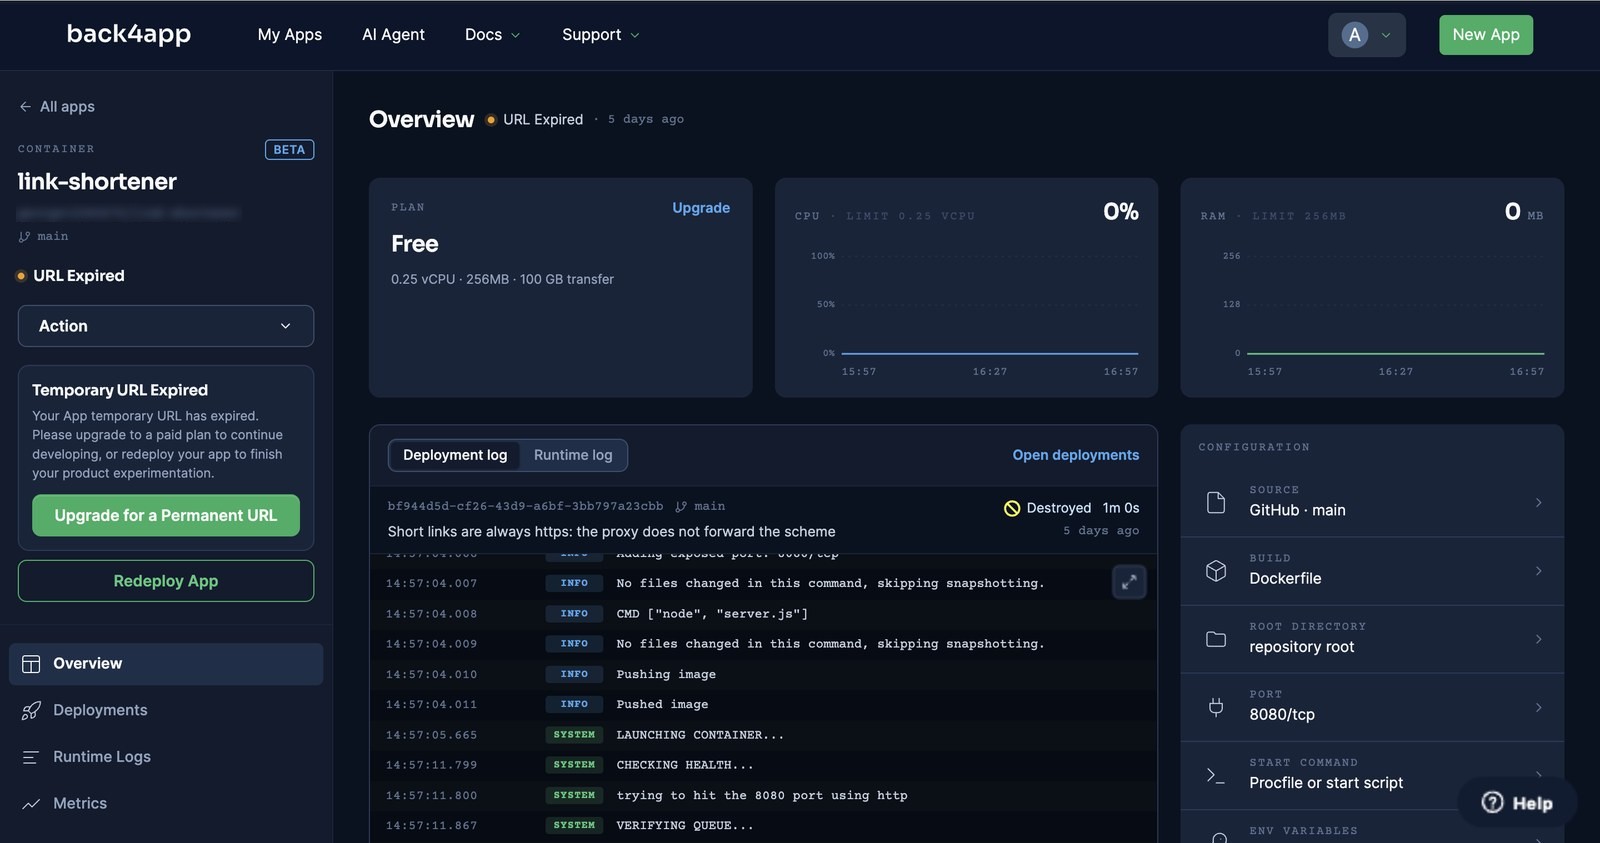
Em um segundo app pegamos as linhas do log: The Back4app custom domain has expired for free plan → COOLING DOWN… → FINISHING CONTAINER… → DEPLOYMENT DESTROYED, com um minuto de intervalo entre elas.
O card da dashboard então diz Your App temporary URL has expired. Please upgrade to a paid plan to continue developing, or redeploy your app to finish your product experimentation. Um redeploy reinicia a hora.
Quanto custa o “24/7”, e o que muda?
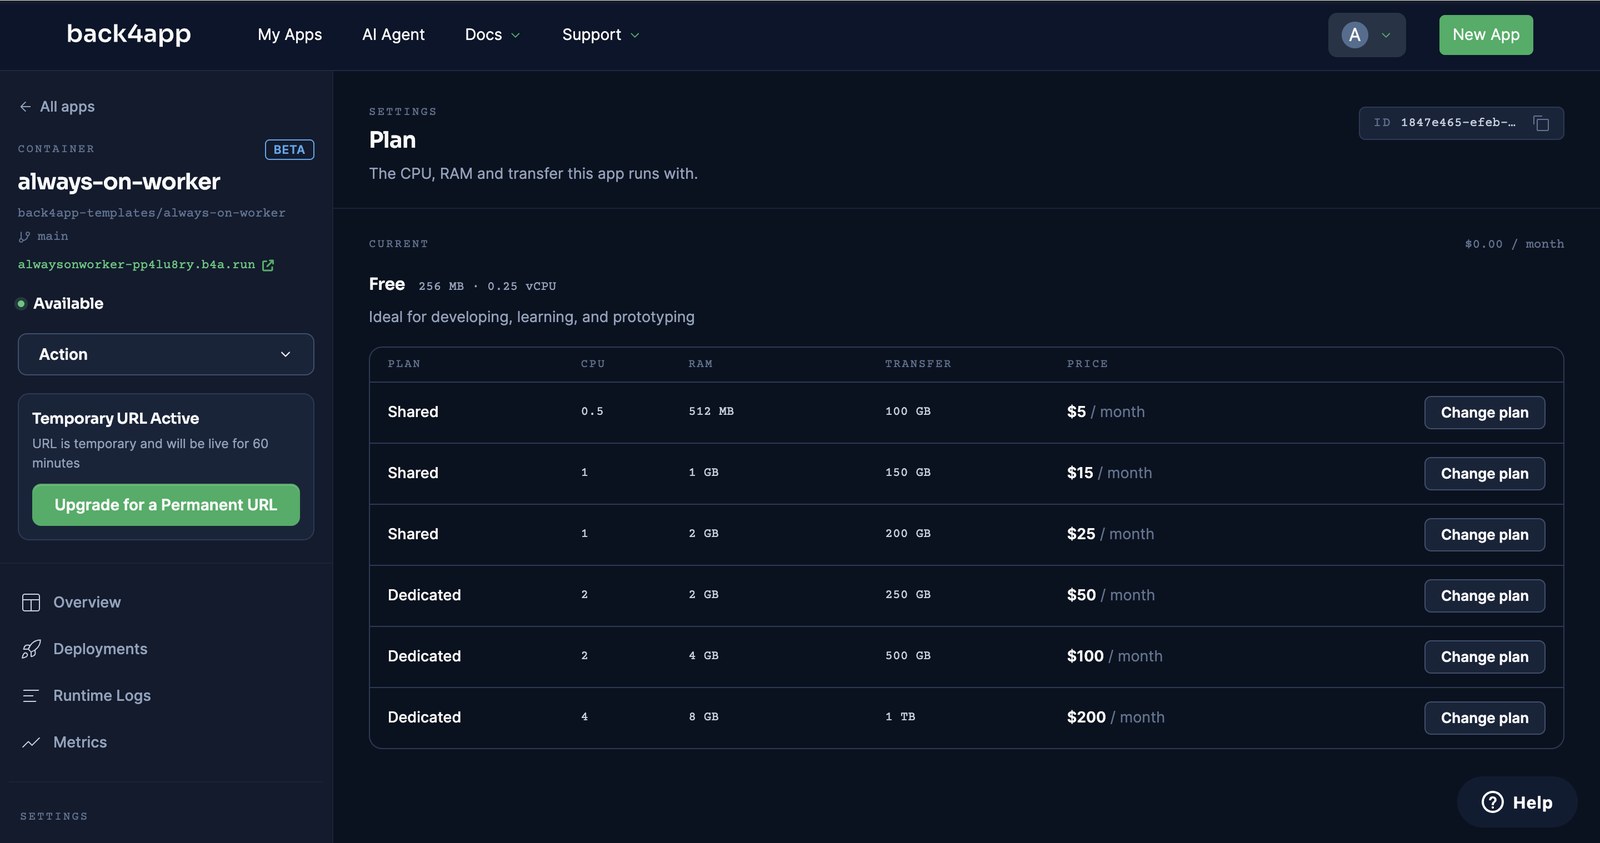
Cinco dólares por mês pelo menor plano pago, e a troca de plano sozinha refez o deploy do app na mesma URL. Plan → Upgrade abre a tabela; Shared 0,5 vCPU / 512 MB / 100 GB de transferência custa US$ 5/mês, Shared 1 vCPU / 1 GB custa US$ 15, e os planos dedicados começam em US$ 50 (tudo em 16 de setembro de 2026 — confira a página de preços em vez deste post).
Trocamos o plano na manhã seguinte. Sem clicar em Deploy, o log mostrou PREPARING DEPLOYMENT às 12:35:37 e DEPLOYMENT READY às 12:36:41 — 63 segundos — na mesma URL b4a.run; o card Temporary URL tinha sumido. Às 12:37:37 o container escreveu o heartbeat #61. O número 60 era da tarde anterior, e nada no meio se perdeu, porque nada estava no container.
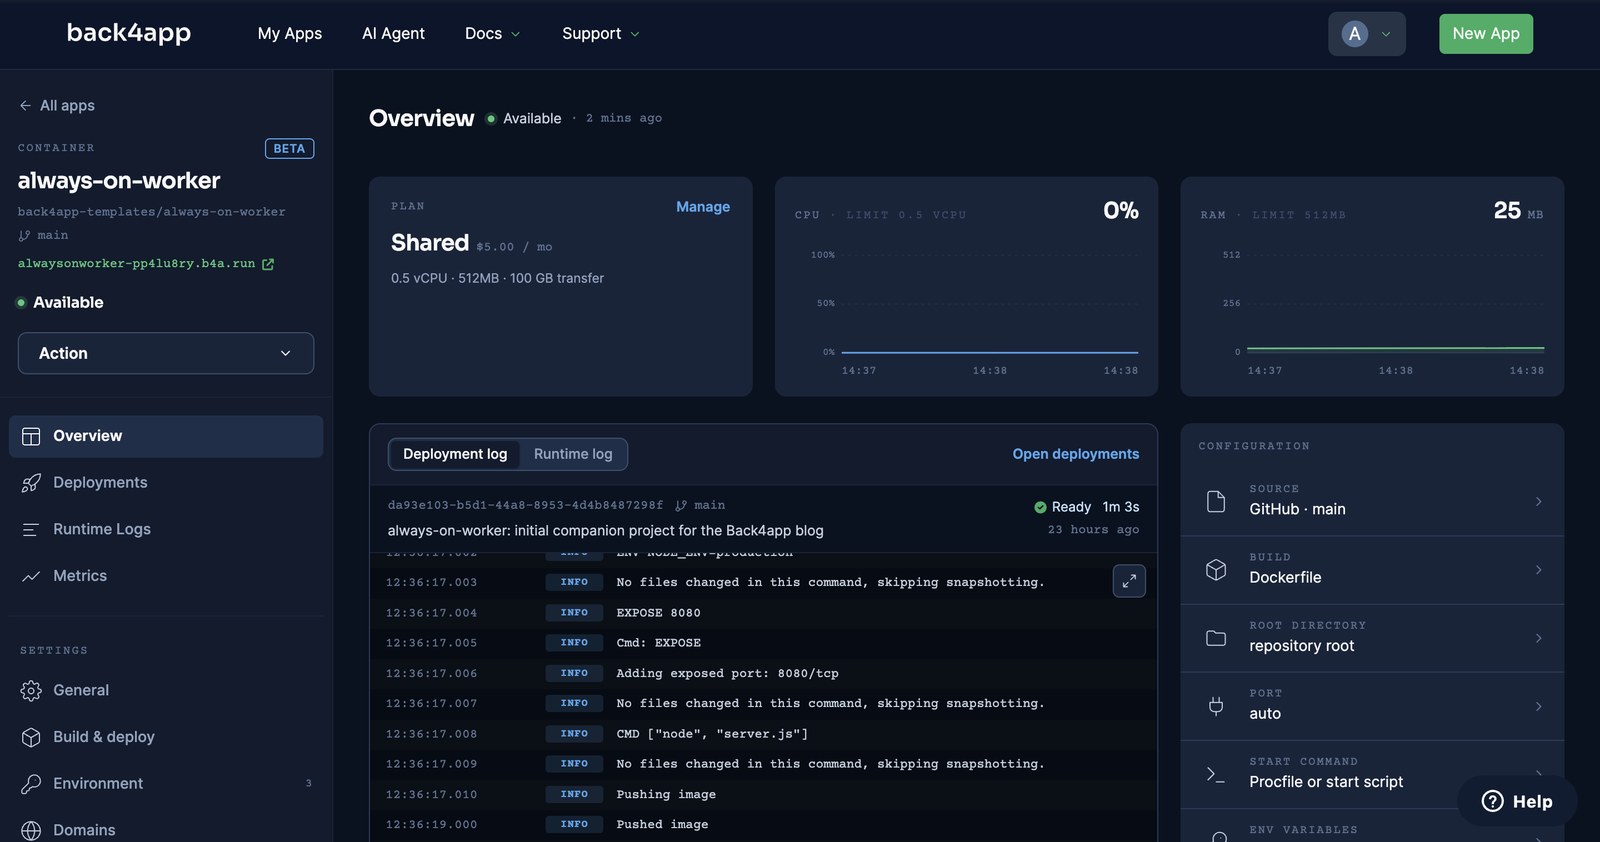
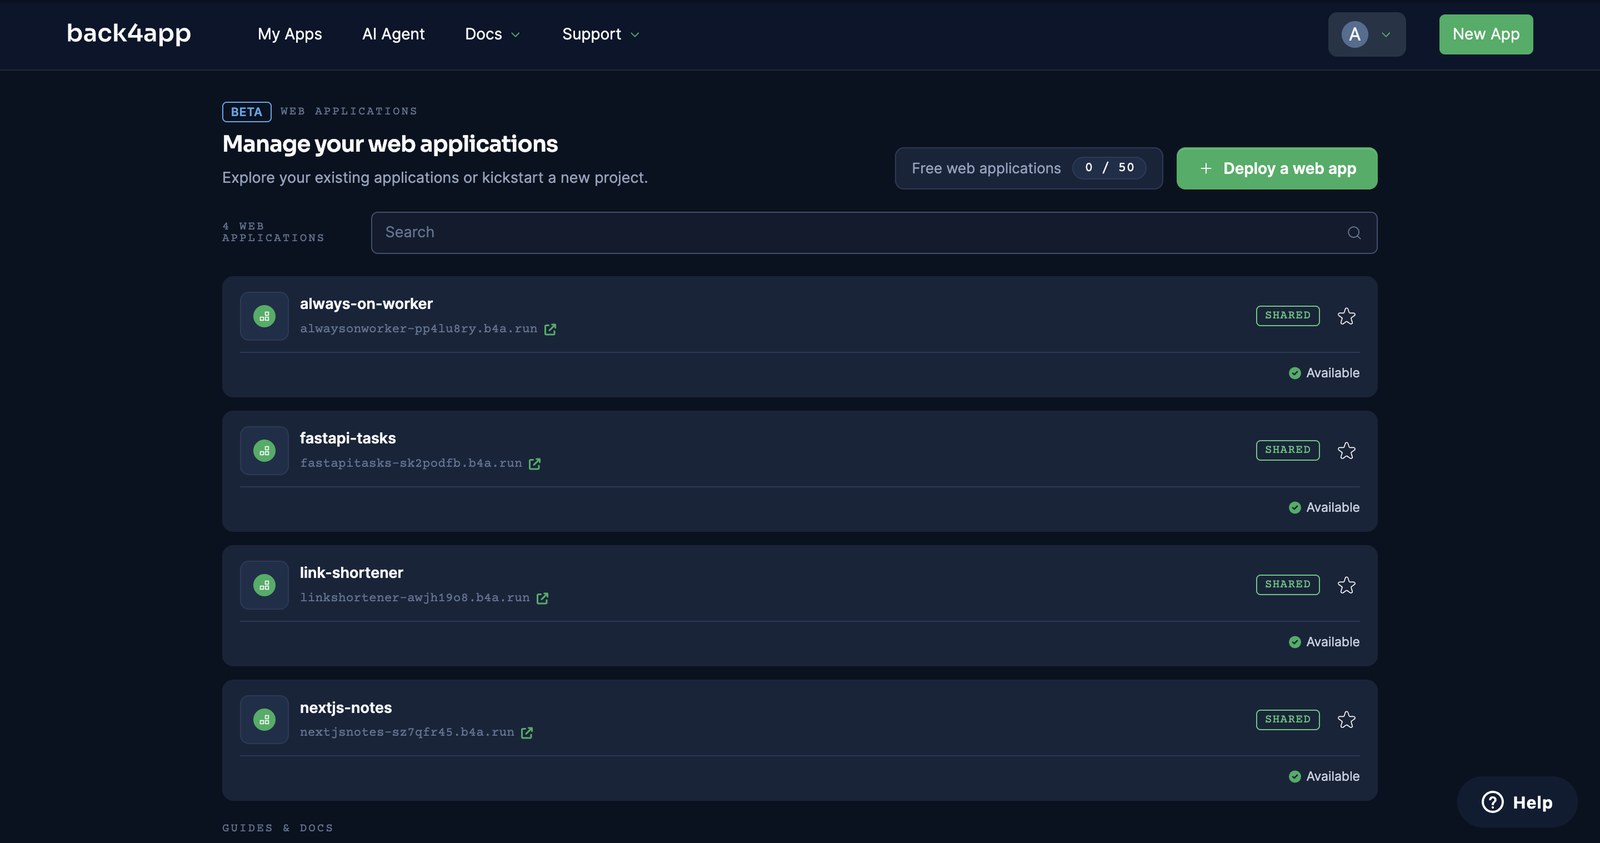
O plano pago também libera o Autodeploy (Settings → Build & deploy). Ligamos, salvamos e fizemos o push de um bump de versão de uma linha às 12:45:02. O webhook do GitHub chegou à plataforma antes de o nosso comando git push retornar: PREPARING às 12:45:05.
DEPLOYMENT READY veio às 12:45:48, e o poller viu a nova versão 44 segundos depois do push. O container antigo continuou respondendo até a troca — zero polls com falha.
Por que o webhook devolve 401? Erros do worker e suas correções
Quebramos o worker de propósito, e a plataforma o quebrou uma vez por nós. Cada entrada começa com o que você vai ver de fato.
401 {"error":"bad signature"} em todo webhook. Três causas, na ordem em que esbarramos nelas: o secret no ambiente do container é diferente do que você usou para assinar; você assinou o JSON parseado em vez dos bytes brutos (ordem de chaves e espaços mudam o hash — capture req.rawBody no callback verify); ou o header é X-Hub-Signature (SHA-1) em vez de X-Hub-Signature-256. Teste com deploy-check.sh antes de ligar o remetente real.
400 {"code":142,"error":"unknown job kind."} ao criar um Job. O hook do backend rejeitou — funcionando como previsto. Adicione o kind à lista em cloud/main.js, refaça o deploy do Cloud Code e prove o redeploy com uma requisição; veja o achado acima sobre o primeiro deploy não enviar nada.
404 not found na URL, dashboard diz URL Expired. A hora gratuita acabou e o container se foi. Refaça o deploy para ganhar outra hora, ou troque o plano; a troca de plano refaz o deploy sozinha.
DEPLOYMENT READY em um container cujas rotas todas falham. A verificação da plataforma só precisa que a porta responda — um 404 passou no nosso teste —, então uma chave errada ou um handler que travou não é pego na hora do deploy. Rode deploy-check.sh contra a URL depois de cada deploy; esse é o health check.
Success on deploying your changes! mas o hook não faz nada. O primeiro deploy de Cloud Code em um backend novo não envia nenhum arquivo. Olhe Logs → System em busca de main.js not found, edite o arquivo no editor e faça o deploy de novo.
Os heartbeats param, mas /healthz continua respondendo. O save() do timer está falhando — uma chave revogada, um backend pausado, uma classe Heartbeat deixada somente leitura. A rota não toca o backend, então continua verde. Nossa rota /stats toca; consulte essa no seu monitor de uptime.
Quando um container sempre ativo é a resposta errada?
Pelo nosso próprio manifesto, um post em que só a plataforma ganha não é publicado — então aqui está a outra coluna.
- Seu “bot” só reage a requisições. Um webhook que guarda e responde, sem timers e sem sockets abertos, é trabalho para uma função. Você paga por chamada e nada roda às 03:00.
- Você precisa que o job rode exatamente às 03:00:00.
setIntervalderiva, e um redeploy o zera — o primeiro heartbeat do nosso worker depois da troca de plano veio 60 segundos depois de o processo iniciar, às 12:37:37, não no minuto cheio. Agendas de verdade pertencem a um scheduler que chama a sua rota, ou aos Cloud Jobs agendados do próprio backend. - A fila precisa de garantias de entrega. Nosso loop é um processo pegando a linha pendente mais antiga a cada 5 segundos; duas réplicas disputariam. Se você precisa de exactly-once, retries com backoff e dead letters, use um serviço de fila e mantenha este container como consumidor.
- Você precisa de root, de uma GPU ou de mais de 8 GB. Então você está em território de VPS, e os patches vêm junto.
Se nenhum desses descreve você, um container pequeno que nunca dorme na frente de um backend que nunca esquece é o formato que escolheríamos de novo — a US$ 5/mês, o preço de um VPS pequeno, e ninguém precisa aplicar patch nele.
O que você acrescentaria ao worker em seguida?
Você tem um processo que fica de pé, um webhook que rejeita qualquer coisa sem assinatura, um cron que você audita contando linhas e uma fila que qualquer coisa pode alimentar. Daqui:
- Aponte um remetente real para ele. GitHub → repositório → Settings → Webhooks → sua URL + o mesmo secret; o header
X-Hub-Signature-256é exatamente o que a rota verifica. - Adicione um kind de job. Um branch em
runJob, uma entrada na lista do hook, um push — o autodeploy faz o resto em menos de um minuto. - Alerte sobre o silêncio. Um segundo processo, minúsculo (ou os jobs agendados do backend), que verifica se o
Heartbeatmais recente tem mais de dois minutos é o sistema de monitoramento inteiro.
Todo o código acima está completo e testado — o repositório companion inclui deploy-check.sh, que roda as verificações de health, assinada, sem assinatura e stats contra qualquer URL de deployment que você passar.