Tienes un script que necesita estar despierto todo el tiempo. Un bot que espera mensajes, un webhook que tiene que responder en menos de diez segundos, un job que se ejecuta cada minuto. Y cada página de hosting te ofrece una de dos opciones que no encajan: una función que muere entre solicitudes, o una máquina Linux que ahora te toca parchear.
Esta es la distinción que da sentido al resto del post. Un handler de solicitudes se ejecuta cuando alguien lo llama. Un proceso siempre activo se ejecuta porque existe: los timers, los bucles y los sockets abiertos lo necesitan.
El segundo tipo es el motivo por el que la gente alquila un VPS, y es el tipo que una plataforma de containers puede ejecutar por ti si mantiene vivo el container.
Los otros tres posts sobre containers tratan de apps que responden a solicitudes: una app web en Node, un servicio FastAPI y una página SSR en Next.js.
Este trata del proceso que tiene que seguir en pie entre solicitudes.
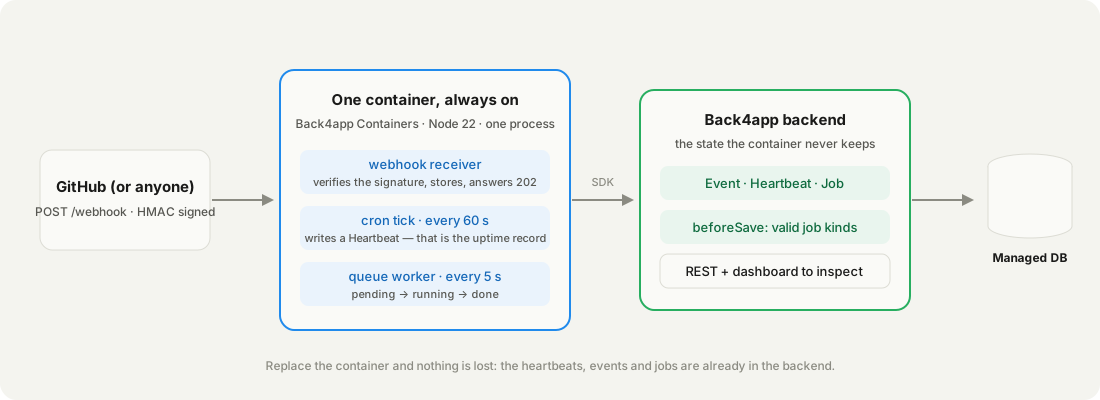
Escribimos un único proceso Node de 75 líneas que hace los tres trabajos (un receptor de webhooks firmados al estilo de GitHub, un tick de cron cada 60 segundos y un worker de cola cada 5 segundos) con todo el estado en un backend gestionado.
Lo desplegamos, lo medimos, vimos cómo el plan Free lo mataba exactamente a la hora y lo pasamos a un plan de US$ 5 al mes, donde lleva escribiendo un heartbeat por minuto desde entonces. Todo lo que sigue sale de esa ejecución, el 15 y 16 de septiembre de 2026.
Consigue el código funcionando: el repositorio companion está en github.com/templates-back4app/always-on-worker — server.js, Dockerfile, cloud/main.js y deploy-check.sh, que lanza un webhook firmado y otro sin firmar contra un deployment y comprueba las dos respuestas.
¿Qué exige realmente estar “siempre activo”?
Tres cosas, y la mayoría de las páginas de hosting solo mencionan la primera: un proceso que no se detiene entre solicitudes, una URL HTTPS pública a la que lleguen los webhooks y un sitio donde viva el estado que no sea el proceso. Si falta la tercera, cada reinicio borra tu cola.
| Lo que necesita el trabajo | Por qué un handler de solicitudes no puede hacerlo | Dónde vive en este post |
|---|---|---|
| Un timer que se dispara cada minuto | Nadie llama a un handler a las 03:00 | Container, tick de cron |
| Un bucle que sondea una cola cada 5 s | Los handlers no tienen “entre solicitudes” | Container, bucle del worker |
| Una URL que responde a webhooks en segundos | Los arranques en frío se comen el timeout de la entrega | Container, /webhook |
| Estado que sobrevive al proceso | El container es desechable | Backend, tres clases |
| Una forma de saber que de verdad estuvo en pie | “Debería estar corriendo” no es una métrica | Backend, recuento de heartbeats |
La respuesta clásica es un VPS: una máquina de US$ 5, cron, pm2, y ahora eres la persona que parchea OpenSSL. La respuesta serverless cubre el webhook y, con un scheduler, el timer, pero no el bucle, ni el socket abierto que mantiene un bot. Un container que una plataforma mantiene vivo cubre las cinco filas sin el parcheo.
Back4app es la que probamos porque las dos mitades salen de una sola cuenta: una app de backend con base de datos gestionada y hooks, y una app de container que ejecuta el Dockerfile y, en un plan de pago, lo mantiene en marcha. El resto del post es el recorrido medido por las dos.
Un proceso que debe estar despierto entre eventos es toda la razón por la que la gente alquila servidores. Es la única parte por la que merece la pena pagar.
¿Qué corre dentro del container siempre activo?
Un único proceso Express con tres trabajos que no comparten nada más que el backend. POST /webhook verifica una firma HMAC al estilo de GitHub y guarda el evento. Un setInterval escribe un Heartbeat cada 60 segundos: cuéntalos después y tendrás el uptime real. Un segundo intervalo toma el Job pendiente más antiguo cada 5 segundos y lo completa.
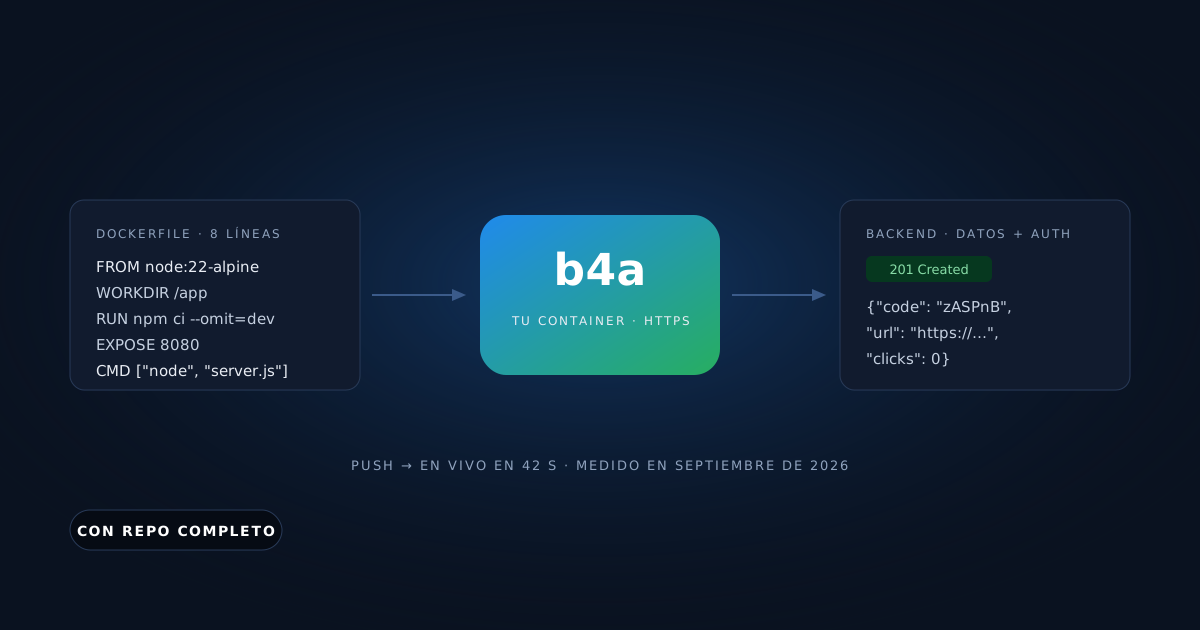
El Dockerfile completo son ocho líneas. La plataforma lee el puerto de EXPOSE:
# Stack: Docker | Node.js 22 (alpine) | File: Dockerfile
FROM node:22-alpine
WORKDIR /app
COPY package*.json ./
RUN npm ci --omit=dev
COPY . .
ENV NODE_ENV=production
EXPOSE 8080
CMD ["node", "server.js"]
La ruta del webhook es la parte que la gente hace mal. Necesita el body sin procesar para la firma, una comparación en tiempo constante y una respuesta rápida: guarda primero y haz el trabajo después:
// Stack: Node.js 22.x | Express 5.x + Parse JS SDK 8.x | File: server.js (webhook)
app.use(express.json({ verify: (req, _res, buf) => { req.rawBody = buf; } }));

app.post("/webhook", async (req, res) => {
  const sig = req.get("x-hub-signature-256") ?? "";
  const expected = "sha256=" + createHmac("sha256", WEBHOOK_SECRET).update(req.rawBody).digest("hex");
  if (!WEBHOOK_SECRET || sig.length !== expected.length || !timingSafeEqual(Buffer.from(sig), Buffer.from(expected))) {
    return res.status(401).json({ error: "bad signature" });
  }
  const ev = new Parse.Object("Event");
  ev.set("source", req.get("x-github-event") ?? "unknown");
  ev.set("payload", req.body);
  await ev.save();
  res.status(202).json({ stored: ev.id });
});
El cron y el worker son dos timers. Ninguno guarda en memoria nada que importe:
// Stack: Node.js 22.x | Express 5.x + Parse JS SDK 8.x | File: server.js (cron + queue)
setInterval(async () => {                       // 1. cron: a heartbeat every minute
  const hb = new Parse.Object("Heartbeat");
  hb.set("at", new Date()); hb.set("up_s", Math.round((Date.now() - startedAt) / 1000));
  await hb.save();
}, 60_000);

setInterval(async () => {                       // 2. queue: oldest pending Job, every 5 s
  const job = await new Parse.Query("Job").equalTo("status", "pending").ascending("createdAt").first();
  if (!job) return;
  job.set("status", "running"); await job.save();
  const t0 = Date.now();
  const result = await runJob(job.get("kind"), job.get("input"));
  job.set("status", "done"); job.set("result", result); job.set("ms", Date.now() - t0);
  await job.save();
}, 5_000);Necesitas una cuenta gratuita de Back4app, una cuenta de GitHub, curl y openssl. Nada de Docker en tu máquina: la plataforma construye la imagen, y este post se produjo en un Mac sin Docker instalado.
¿Dónde va el estado?
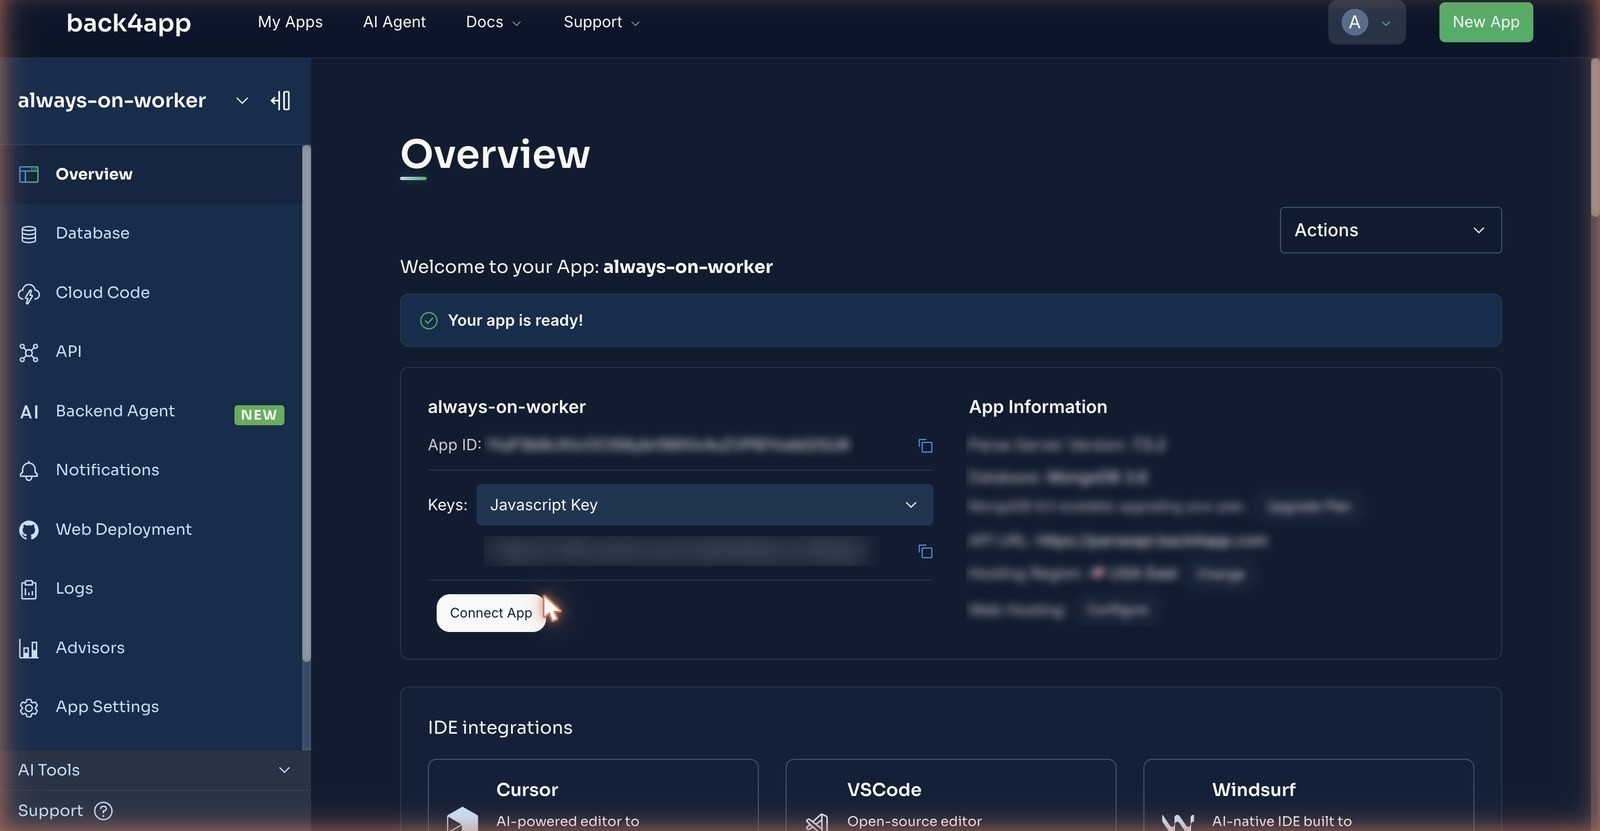
A una app de backend: tres clases que el container crea en la primera escritura, y una regla que el container no puede saltarse. Dashboard → New App → Build your Backend, ponle nombre, Create; la página Overview muestra el App ID y, en el desplegable Keys, la JavaScript key. Esos dos valores son toda la configuración que necesita el container.
La JavaScript key que envía el container es una clave de cliente: lo que puede hacer lo deciden los permisos de las clases, que medimos cerrojo a cerrojo en otro post.
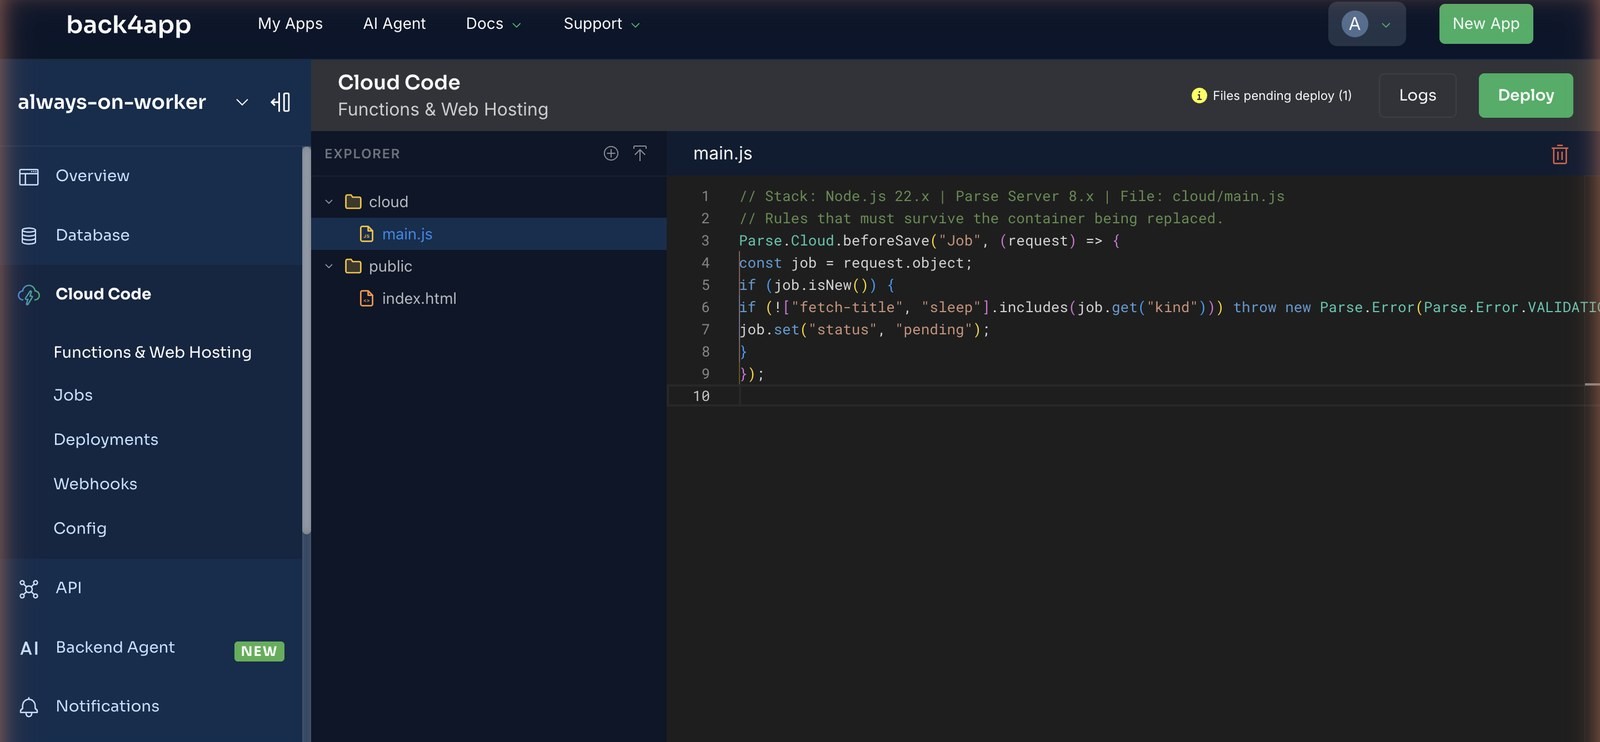
La única regla vive en Cloud Code, dentro del backend. Cualquier cosa puede crear un Job (un curl, otro servicio, el AI Agent) y el hook decide qué es un job válido. Un job con un kind que el worker no conoce nunca llega a la cola:
// Stack: Node.js 22.x | Parse Server 8.x | File: cloud/main.js
Parse.Cloud.beforeSave("Job", (request) => {
  const job = request.object;
  if (job.isNew()) {
    if (!["fetch-title", "sleep"].includes(job.get("kind")))
      throw new Parse.Error(Parse.Error.VALIDATION_ERROR, "unknown job kind.");
    job.set("status", "pending");
  }
});
Pégalo en Cloud Code → cloud/main.js en la dashboard del backend y pulsa Deploy. Después demuéstralo con una solicitud: enviamos {"kind":"rm-rf"} y recibimos 400 {"code":142,"error":"unknown job kind."}, y {"kind":"sleep","input":{"ms":1500}} volvió con 201 y el status ya fijado en pending por el hook.
Aquí hay un job creado de dos formas. Al worker nunca le importa cuál de las dos lo creó:
// Stack: Node.js 22.x | Parse JS SDK 8.x | File: any Node process with the App ID and JS key
const job = new Parse.Object("Job");
job.set("kind", "fetch-title");
job.set("input", { url: "https://www.back4app.com/" });
await job.save();               // the hook sets status = "pending"; the worker picks it up within 5 s
# Stack: bash | Endpoint: POST /classes/Job
curl -X POST \
-H "X-Parse-Application-Id: $APP_ID" \
-H "X-Parse-REST-API-Key: $REST_KEY" \
-H "Content-Type: application/json" \
-d '{"kind": "fetch-title", "input": {"url": "https://www.back4app.com/"}}' \
"$BASE/classes/Job"
# {"objectId":"…","createdAt":"…","status":"pending"} ← HTTP 201Mismo objeto, mismo hook. La forma REST es lo que el SDK envía por debajo.
¿Cómo despliegas un worker que no tiene página web?
Sube el repositorio a GitHub y, en el lado de Containers, New App → Deploy from GitHub. La primera vez, GitHub te pide instalar la app de Back4app Containers en los repositorios que elijas; la lista de repositorios de la dashboard se actualiza en cuanto terminas.
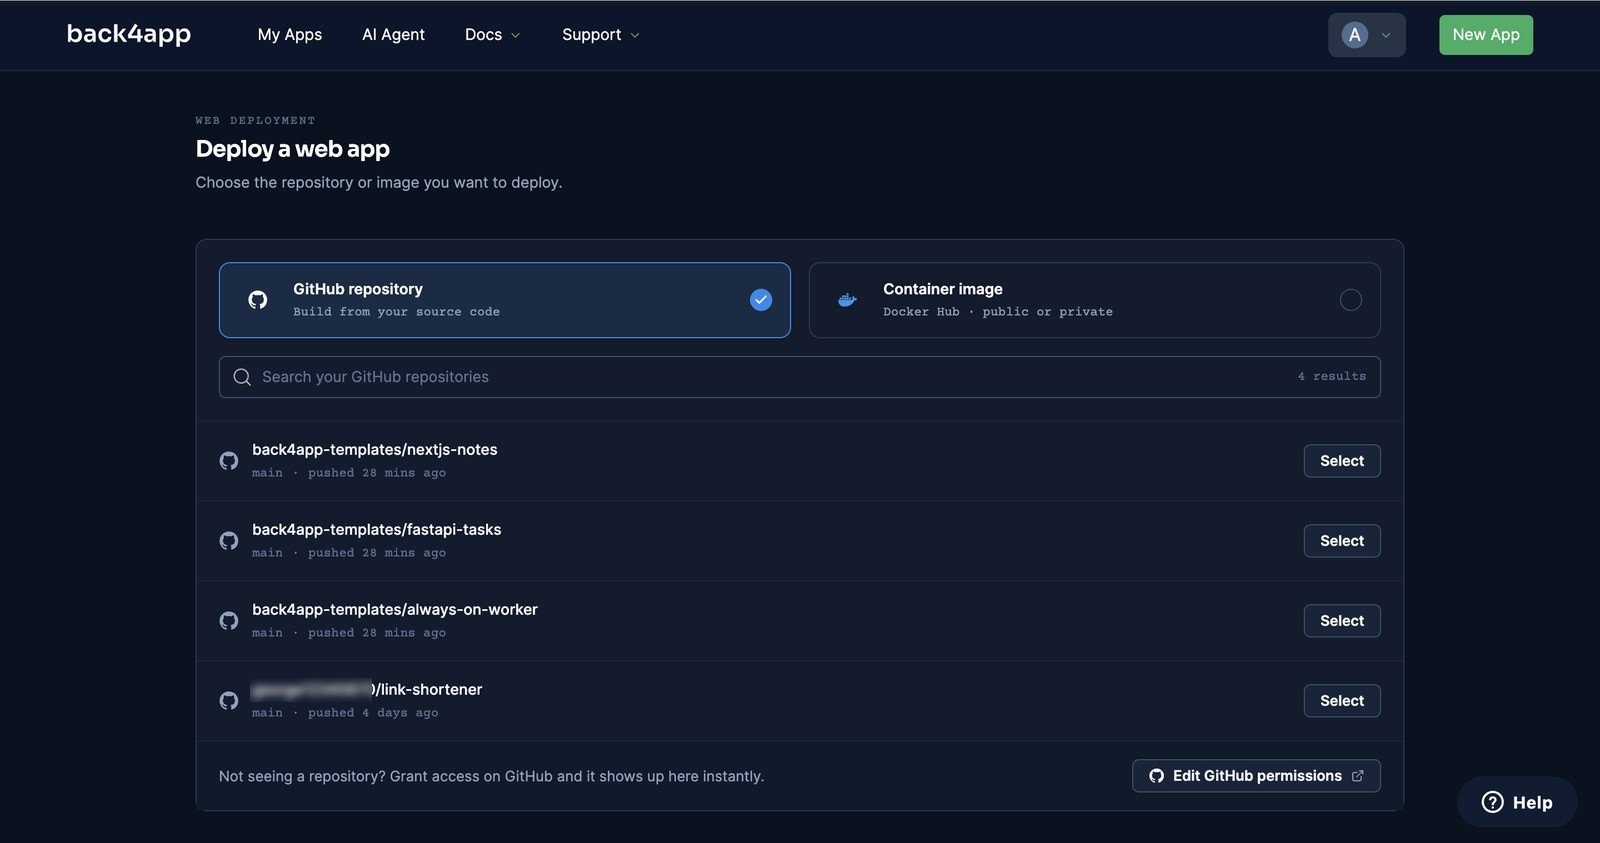
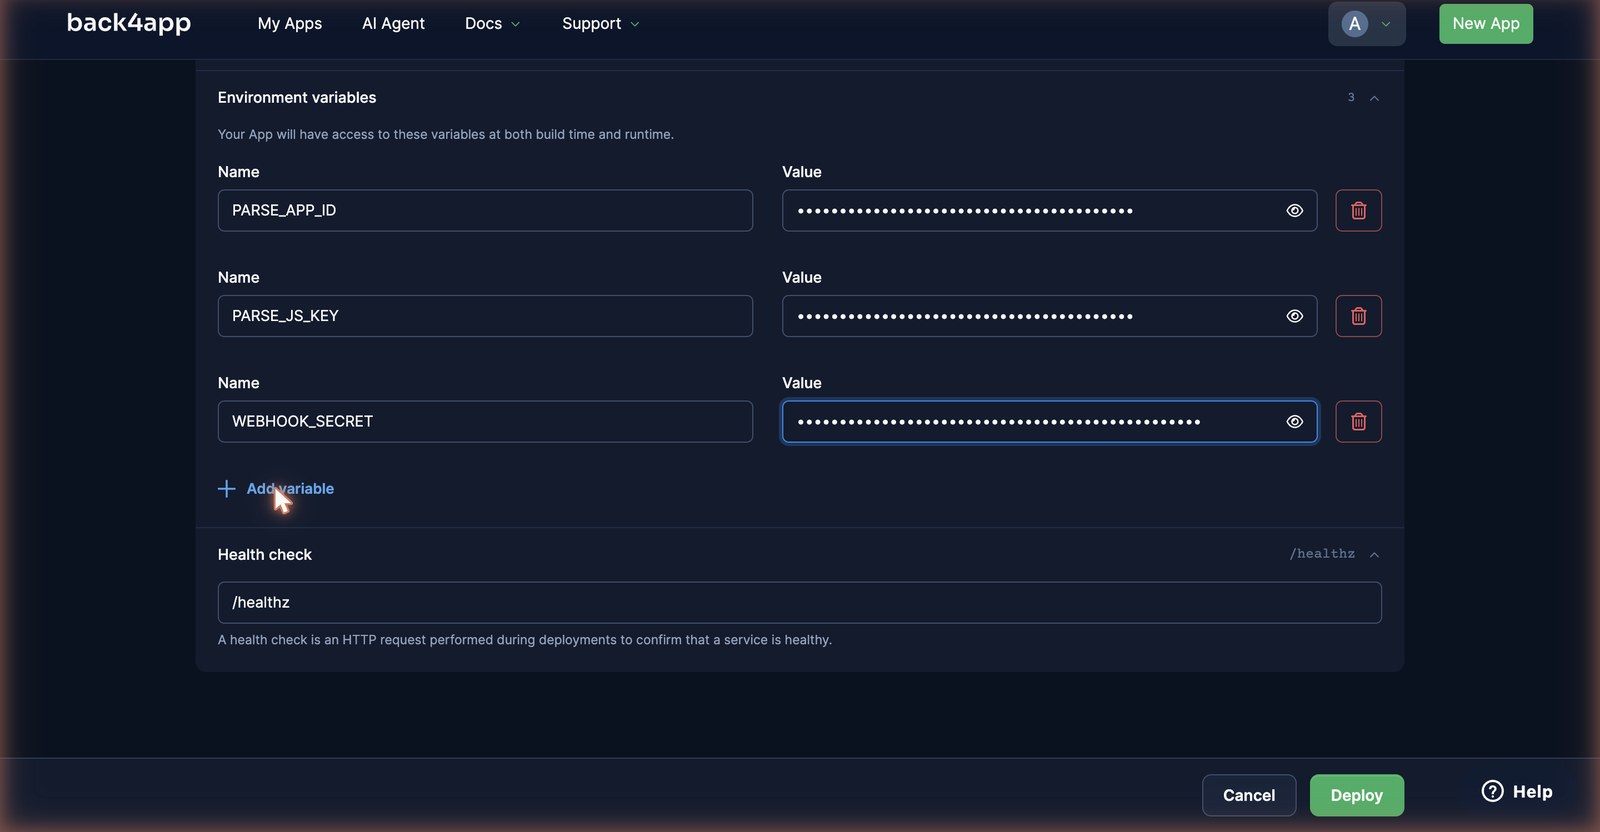
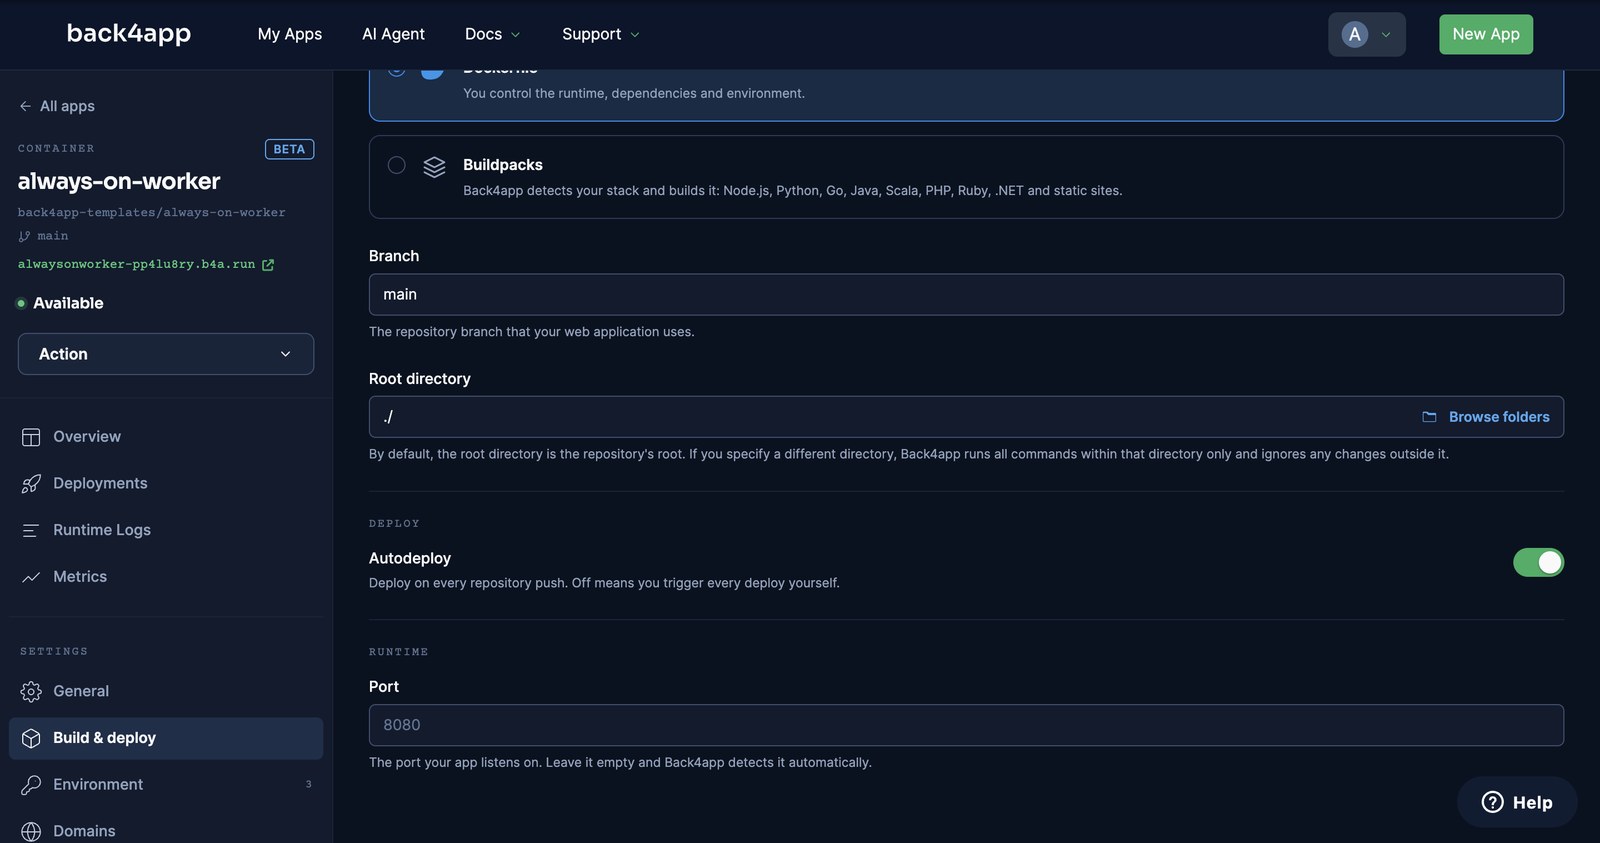
Configurar. Selecciona el repositorio; el formulario detectó el Dockerfile y ofreció un buildpack de Node.js como alternativa. Dejamos el puerto en automático (lee EXPOSE 8080), añadimos tres variables de entorno (PARSE_APP_ID, PARSE_JS_KEY, WEBHOOK_SECRET) y cambiamos Health check de / a /healthz.
Desplegar. Hicimos clic a las 14:55:08. El botón mostró “Deploying…” durante 20 segundos antes de que apareciera la página de la app, y después el log recorrió PREPARING → FETCHING GITHUB REPOSITORY → BUILDING IMAGE → LAUNCHING CONTAINER → CHECKING HEALTH → DEPLOYMENT READY hasta las 14:56:05.
A las 14:56:11, /healthz ya respondía con el número de versión.
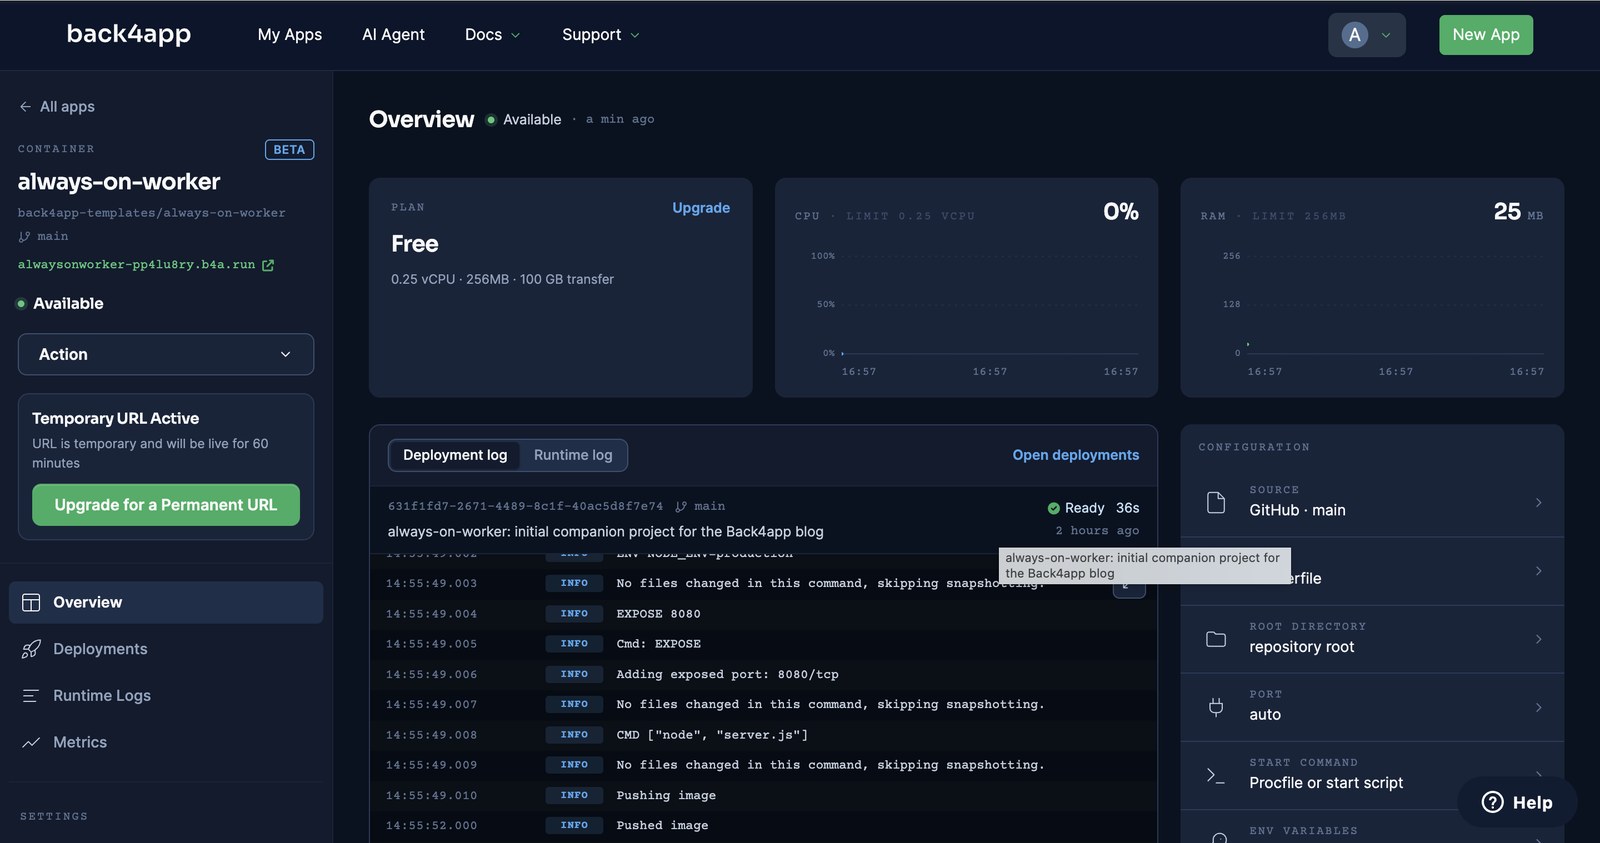
Cómo lo medimos: un cronómetro desde el clic en Deploy hasta DEPLOYMENT READY, plan Free, un deploy el 15 de septiembre de 2026. El tiempo de push a producción es un push con autodeploy activado, en el plan Shared al día siguiente, observado por un bucle que sondeaba /healthz en busca de la cadena de la versión nueva.
deploy-check.sh, en el repositorio, hace lo que harías a mano: un POST /webhook firmado (202 {"stored":"…"}), el mismo body sin firmar (401) y después /stats. Un Job creado por la REST API a las 14:56:38,6 fue tomado y terminado a las 14:56:41,4: el bucle de 5 segundos funcionó en su primer tick.
# Stack: bash | File: deploy-check.sh (the signed call)
BODY='{"action":"opened","number":1}'
SIG="sha256=$(printf '%s' "$BODY" | openssl dgst -sha256 -hmac "$WEBHOOK_SECRET" | sed 's/^.* //')"
curl -X POST -H "Content-Type: application/json" -H "X-GitHub-Event: pull_request" \
     -H "X-Hub-Signature-256: $SIG" -d "$BODY" "https://alwaysonworker-<id>.b4a.run/webhook"
# {"stored":"…"}  ← HTTP 202
¿Cómo se ven los heartbeats y los jobs en la base de datos?
Tres pantallas de la dashboard del backend, y cada fila que aparece en ellas la escribió el container de arriba: sin datos de semilla, sin schema definido a mano. Esta es la mitad de “sin servidores que gestionar” que el container nunca te enseña.
Overview — de dónde salen las dos variables. Dashboard → New App → Build your Backend → Create. La página Overview muestra el App ID y, en el desplegable Keys, la JavaScript key que usa el worker. Son PARSE_APP_ID y PARSE_JS_KEY en el formulario del container, y nada más de la base de datos existe en el lado del container.
Cloud Code — donde vive la regla. cloud/main.js abierto en el editor, con el hook beforeSave("Job") de la sección anterior. El badge de arriba, Files pending deploy (1), es lo que hay que vigilar: en un backend recién creado se queda en (2) después del primer Deploy, y así sabes que no se envió nada.
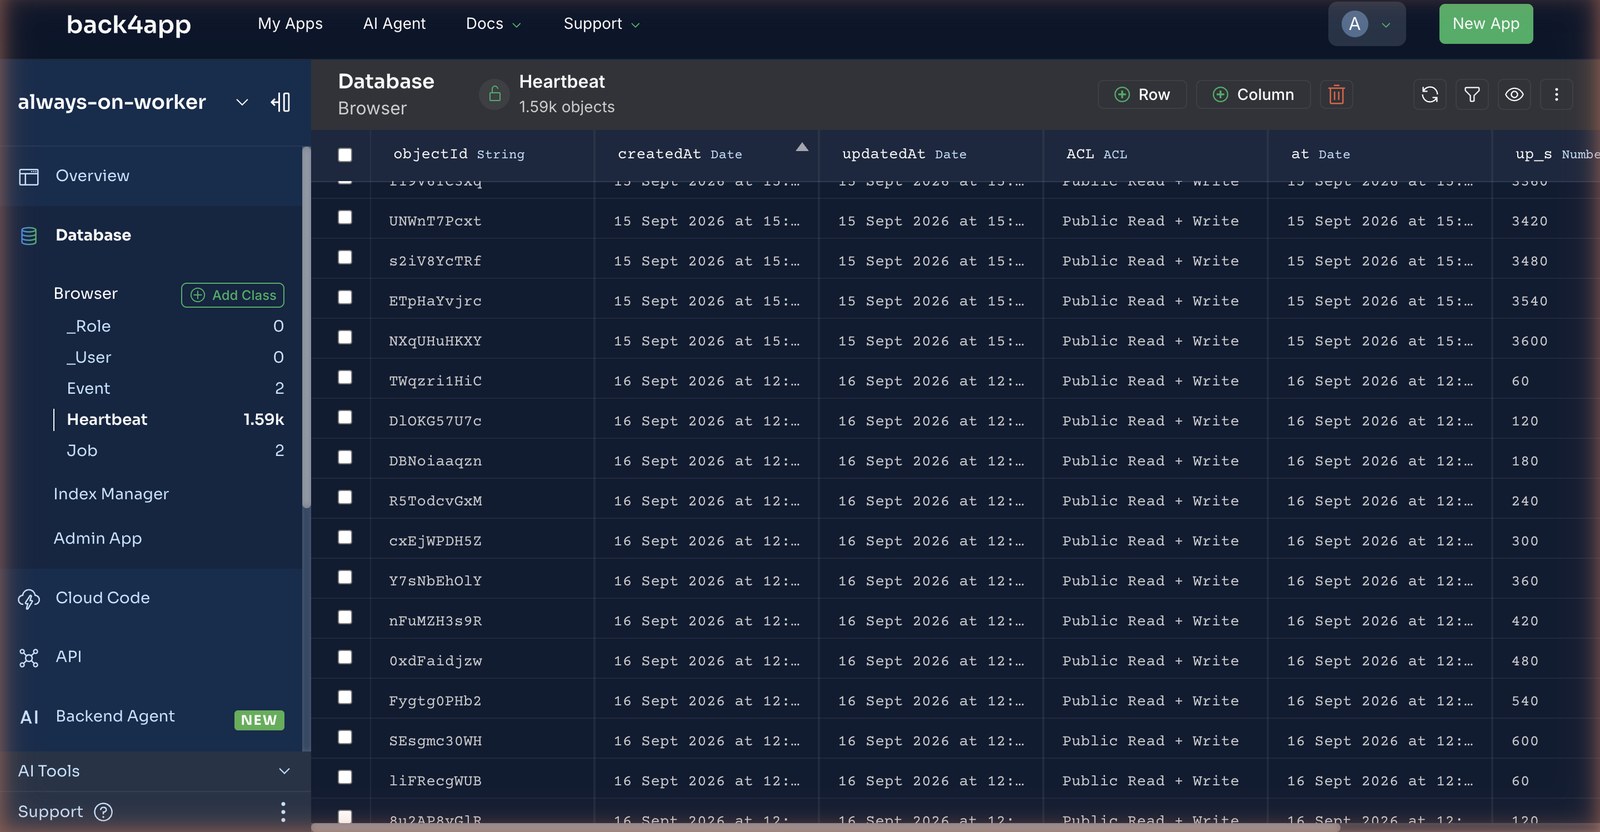
Database Browser — la clase Heartbeat, ordenada por createdAt. El container creó esta clase con su primer save; las columnas at y up_s se infirieron del JSON. Las filas 60 y 61 están una junto a la otra: up_s 3600 el 15 de septiembre, después up_s 60 el 16 de septiembre; el hueco de 20 horas en el que el container gratuito no existió.
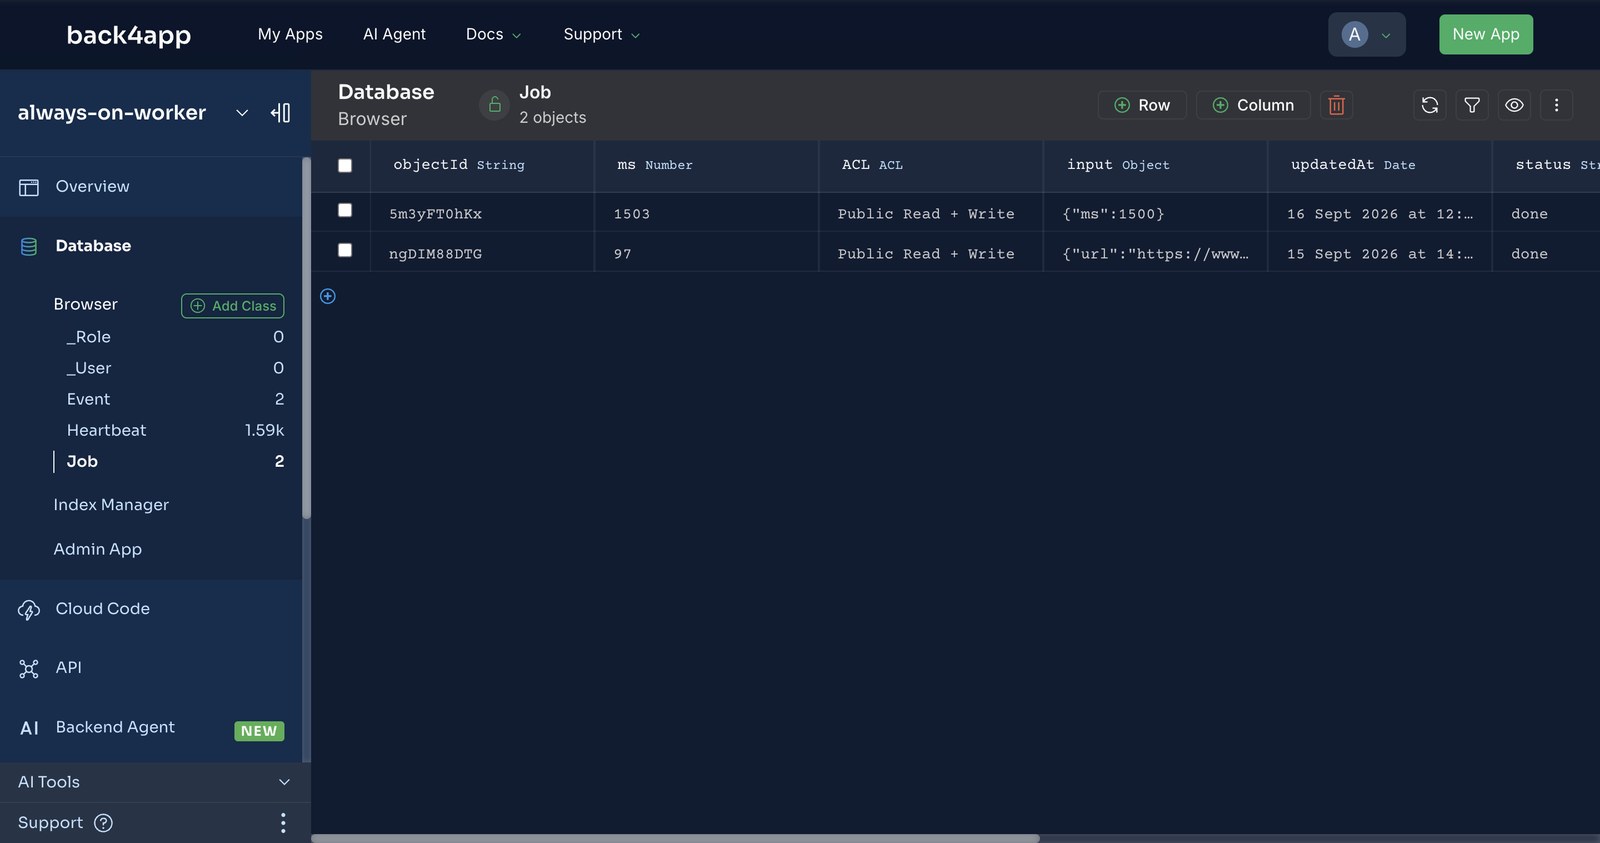
Database Browser — la clase Job. Dos jobs, los dos done: el job fetch-title que creó la llamada REST (ms 97) y un job sleep (ms 1503). El worker escribió status, result y ms; el hook escribió el pending inicial; quien lo creó escribió solo kind e input.
¿Cuánto tiempo lo mantiene en marcha el plan Free?
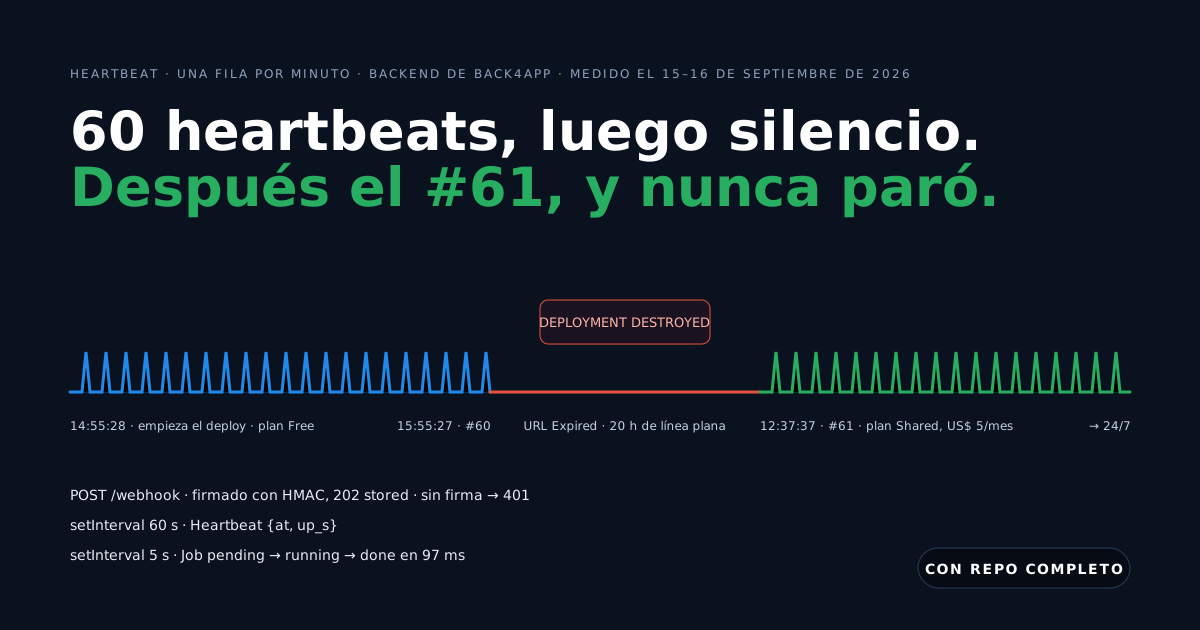
Sesenta minutos, contados desde el momento en que empieza el deploy, y después el container se destruye, no se pausa. Este es el hallazgo que cambia la forma del post, así que aquí está exactamente lo que vimos el 15 de septiembre de 2026.
El Overview mostró una tarjeta en cuanto la app arrancó: Temporary URL Active — URL is temporary and will be live for 60 minutes. Teníamos un sondeo sobre /healthz y sobre el recuento de heartbeats en el backend, una vez por minuto.
El deploy empezó a las 14:55:28. A las 15:55:27 la URL respondió 404 not found. El backend tenía exactamente 60 heartbeats y nunca recibió el 61: el timer dentro del container se había detenido, porque el container también.
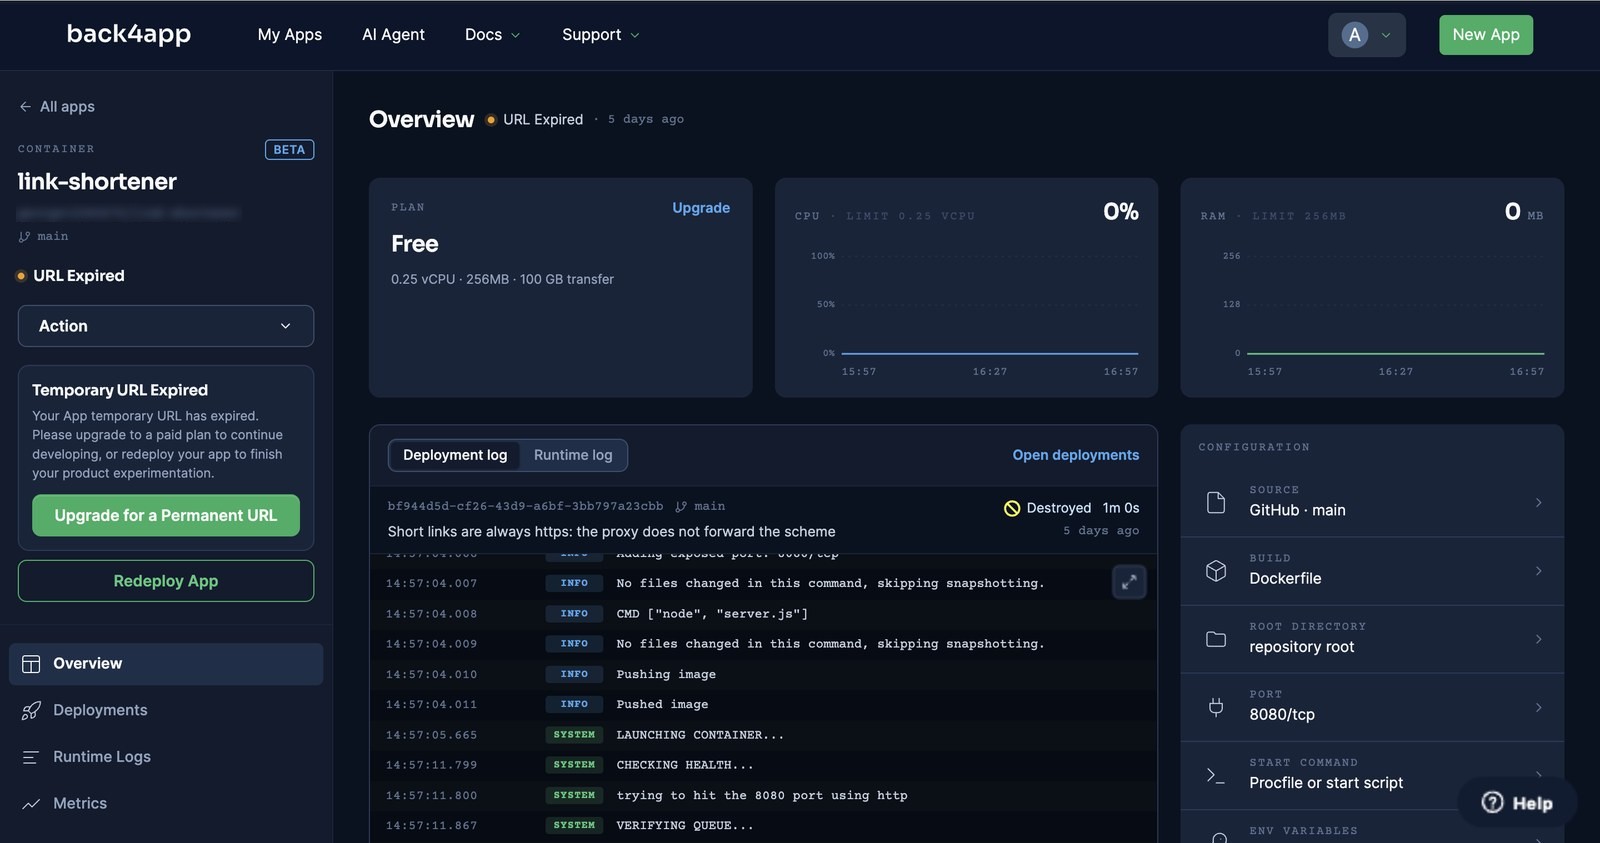
En una segunda app capturamos las líneas del log: The Back4app custom domain has expired for free plan → COOLING DOWN… → FINISHING CONTAINER… → DEPLOYMENT DESTROYED, con un minuto de diferencia entre ellas.
La tarjeta de la dashboard pasa entonces a decir Your App temporary URL has expired. Please upgrade to a paid plan to continue developing, or redeploy your app to finish your product experimentation. Un redeploy reinicia la hora.
¿Cuánto cuesta el “24/7” y qué cambia?
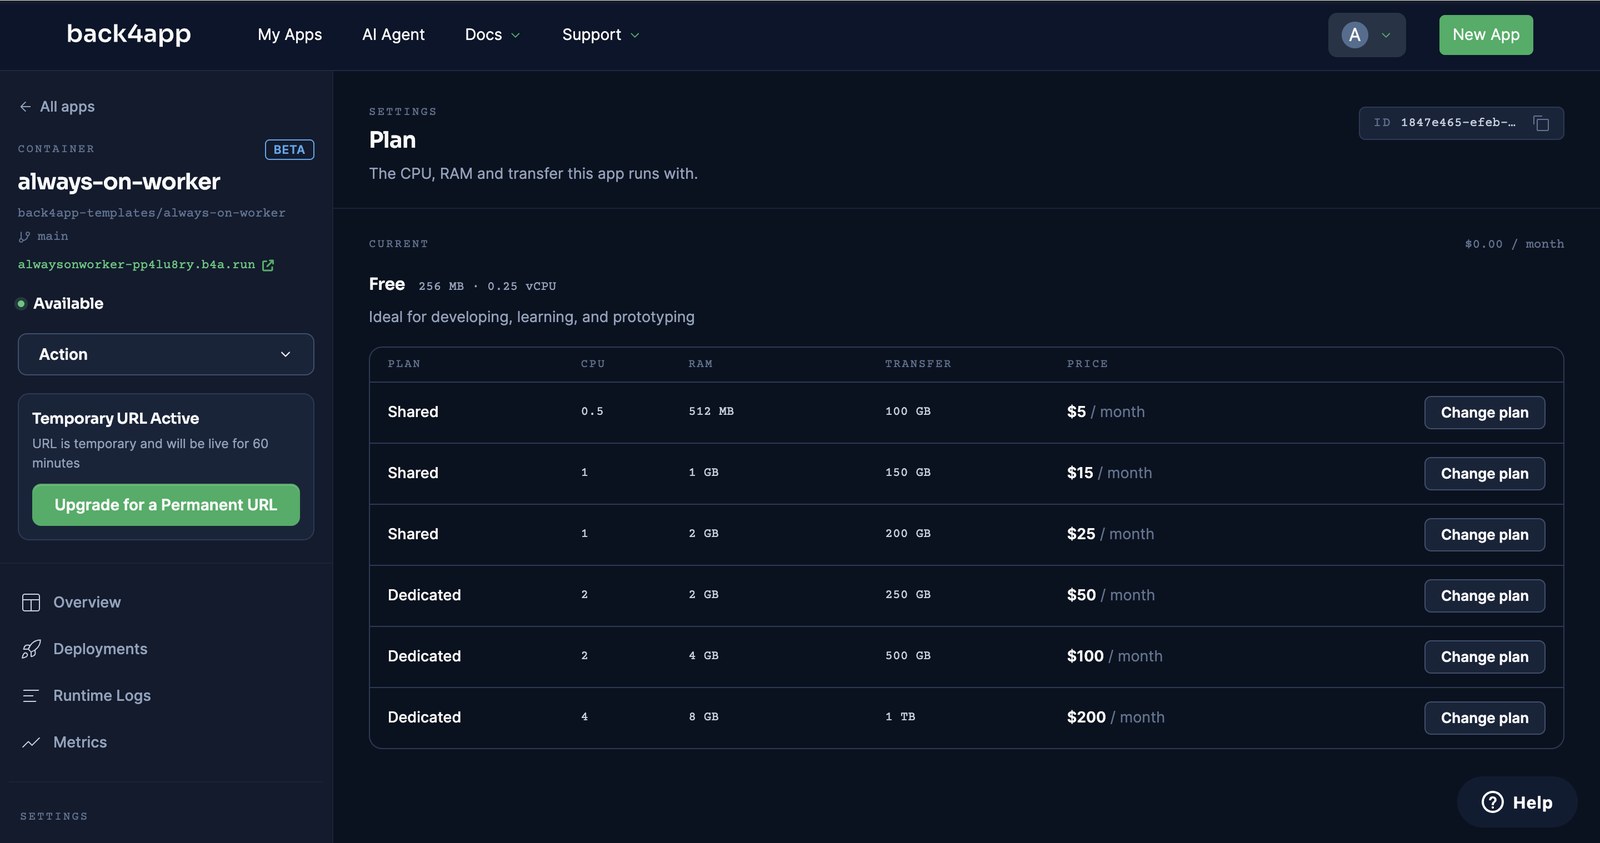
Cinco dólares al mes por el plan de pago más pequeño, y el cambio de plan por sí solo volvió a desplegar la app en la misma URL.
Plan → Upgrade abre la tabla; Shared 0,5 vCPU / 512 MB / 100 GB de transferencia cuesta US$ 5 al mes, Shared 1 vCPU / 1 GB cuesta US$ 15, y los planes Dedicated empiezan en US$ 50 (todo a 16 de septiembre de 2026; consulta la página de precios en lugar de este post).
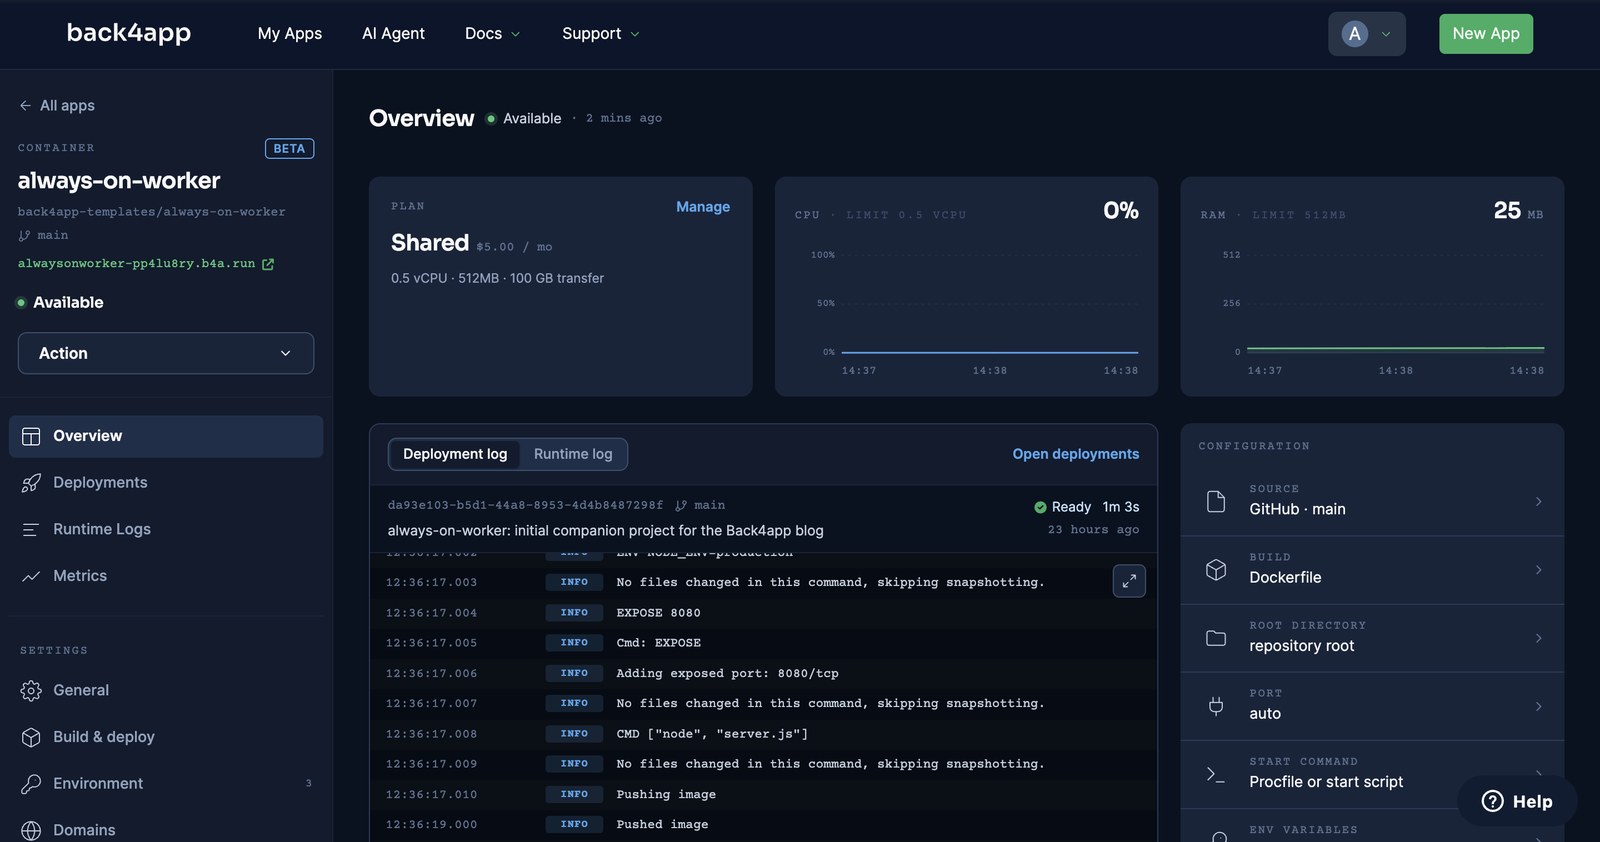
Cambiamos el plan a la mañana siguiente. Sin hacer clic en Deploy, el log mostró PREPARING DEPLOYMENT a las 12:35:37 y DEPLOYMENT READY a las 12:36:41 (63 segundos) en la misma URL b4a.run; la tarjeta Temporary URL había desaparecido.
A las 12:37:37 el container escribió el heartbeat #61. El 60 era de la tarde anterior, y no se perdió nada entre medias, porque no había nada en el container.
El plan de pago también desbloquea Autodeploy (Settings → Build & deploy). Lo activamos, guardamos y subimos un cambio de versión de una línea a las 12:45:02. El webhook de GitHub llegó a la plataforma antes de que nuestro comando git push hubiera terminado: PREPARING a las 12:45:05.
DEPLOYMENT READY llegó a las 12:45:48, y el sondeo vio la versión nueva 44 segundos después del push. El container antiguo siguió respondiendo hasta el intercambio: cero sondeos fallidos.
¿Por qué el webhook devuelve 401? Errores del worker y sus soluciones
Rompimos el worker a propósito, y la plataforma nos lo rompió una vez. Cada entrada empieza por lo que verás de verdad.
401 {"error":"bad signature"} en todos los webhooks. Tres causas, en el orden en que nos las encontramos: el secreto en el entorno del container no coincide con el que usaste para firmar; firmaste el JSON parseado en lugar de los bytes sin procesar (el orden de las claves y los espacios cambian el hash: captura req.rawBody en el callback verify); o el header es X-Hub-Signature (SHA-1) en lugar de X-Hub-Signature-256. Prueba con deploy-check.sh antes de conectar el emisor real.
400 {"code":142,"error":"unknown job kind."} al crear un Job. El hook del backend lo rechazó: funciona como debe. Añade el kind a la lista de cloud/main.js, vuelve a desplegar el Cloud Code y demuestra el redeploy con una solicitud; mira el hallazgo de arriba sobre el primer deploy que no envía nada.
404 not found en la URL, y la dashboard dice URL Expired. La hora gratuita terminó y el container ya no existe. Vuelve a desplegar para conseguir otra hora, o cambia de plan; el cambio de plan redespliega por sí solo.
DEPLOYMENT READY en un container cuyas rutas fallan todas. La comprobación de la plataforma solo necesita que el puerto responda (un 404 la pasó en nuestra prueba), así que una clave incorrecta o un handler que se cae no se detectan en el deploy. Ejecuta deploy-check.sh contra la URL después de cada deploy; ese es el health check.
Success on deploying your changes! pero el hook no hace nada. El primer deploy de Cloud Code en un backend recién creado no envía ningún archivo. Busca main.js not found en Logs → System, edita el archivo en el editor y despliega otra vez.
Los heartbeats se detienen pero /healthz sigue respondiendo. El save() del timer está fallando: una clave revocada, un backend pausado, una clase Heartbeat puesta en solo lectura. La ruta no toca el backend, así que sigue en verde. Nuestra ruta /stats sí lo toca; sondea esa desde tu monitor de uptime.
¿Cuándo es un container siempre activo la respuesta equivocada?
Según nuestro propio manifiesto, un post en el que solo gana la plataforma no se publica, así que aquí está la otra columna.
- Tu “bot” solo reacciona a solicitudes. Un webhook que guarda y responde, sin timers ni sockets abiertos, es trabajo para una función. Pagas por llamada y nada corre a las 03:00.
- Necesitas que el job corra exactamente a las 03:00:00.
setIntervalse desvía, y un redeploy lo reinicia: el primer heartbeat de nuestro worker tras el cambio de plan llegó 60 segundos después de arrancar el proceso, a las 12:37:37, no en el minuto en punto. Los horarios reales van en un scheduler que llame a tu ruta, o en los Cloud Jobs programados del propio backend. - La cola necesita garantías de entrega. Nuestro bucle es un proceso que toma la fila pendiente más antigua cada 5 segundos; dos réplicas competirían entre sí. Si necesitas exactly-once, reintentos con backoff y dead letters, usa un servicio de colas y deja este container como consumidor.
- Necesitas root, una GPU o más de 8 GB. Entonces estás en territorio de VPS, y el parcheo viene con él.
Si ninguno de esos casos es el tuyo, un container pequeño que nunca duerme delante de un backend que nunca olvida es la forma que elegiríamos otra vez: a US$ 5 al mes, el precio de un VPS pequeño, y nadie tiene que parchearlo.
¿Qué añadirías al worker a continuación?
Tienes un proceso que se mantiene en pie, un webhook que rechaza todo lo que no esté firmado, un cron que puedes auditar contando filas y una cola que cualquiera puede alimentar. Desde aquí:
- Apunta un emisor real hacia él. GitHub → repositorio → Settings → Webhooks → tu URL + el mismo secreto; el header
X-Hub-Signature-256es exactamente lo que verifica la ruta. - Añade un tipo de job. Una rama en
runJob, una entrada en la lista del hook, un push: el autodeploy hace el resto en menos de un minuto. - Alerta ante el silencio. Un segundo proceso diminuto (o los jobs programados del backend) que compruebe si el último
Heartbeattiene más de dos minutos es todo el sistema de monitorización.
Todo el código de arriba está completo y probado: el repositorio companion incluye deploy-check.sh, que ejecuta las comprobaciones de health, firmada, sin firmar y stats contra cualquier URL de deployment que le des.