Um gráfico de Gantt é muito bom em mostrar o plano e muito ruim em responder perguntas sobre ele. As barras são o ponto, e as barras também são o motivo de você acabar rastreando dependências com o dedo na tela.
A pergunta que você realmente tem numa segunda-feira é mais estreita: o que atrasou, e o que agora está preso atrás disso. Uma planilha mostra a primeira com formatação condicional. A segunda, ela faz você descobrir no olho.
Este guia move um cronograma de doze atividades para um banco de dados e faz as duas perguntas a ele. A importação levou 502 ms; as quatro queries de que um tracker precisa voltaram em menos de meio segundo cada.
Como fica um cronograma depois que vira linhas?
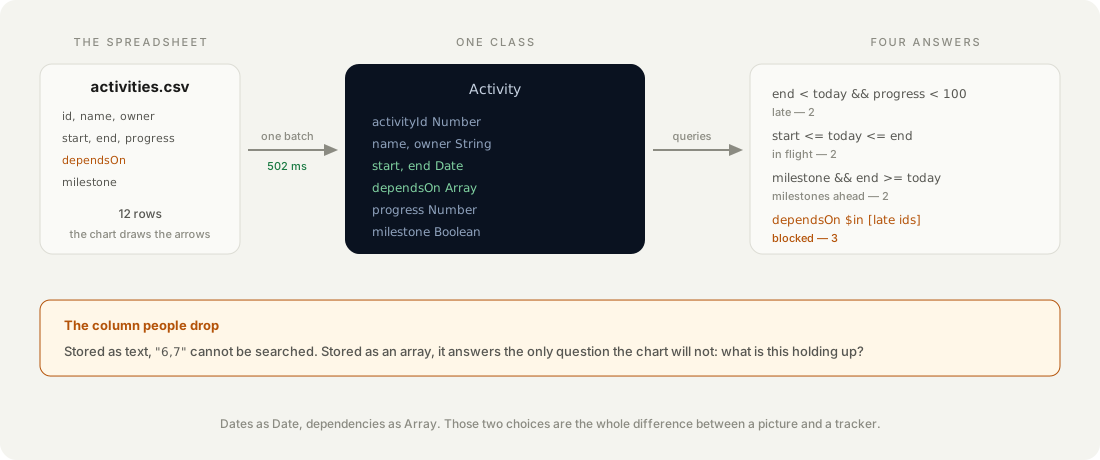
Oito colunas, e só duas delas são interessantes. Uma linha de Gantt é uma atividade com início, fim e uma porcentagem; o que a torna um cronograma, e não uma lista, é a coluna que diz pelo que ela espera.
id  name                   owner           start       end         progress  dependsOn  milestone
5   Import pipeline        Tomas Vidal     2026-09-22  2026-10-03  80                4  false
6   Permissions and roles  Nadia Okonkwo   2026-09-28  2026-10-07  45                4  false
9   Beta with two teams    Nadia Okonkwo   2026-10-12  2026-10-24   0              6,7  true
dependsOn é a coluna que as pessoas deixam de fora quando movem uma planilha para uma ferramenta, porque o gráfico desenha as setas por elas. Perca essa coluna e você fica com a imagem e joga fora a única coisa que responde “e daí?”.
Quais tipos de coluna importam de verdade?
Dois: as datas precisam ser datas, e as dependências precisam ser um array. Todo o resto pode ser o que for mais conveniente.
// Stack: Node 22 | File: import-and-query.mjs
{
  activityId: { type: 'Number' },
  name:       { type: 'String' },
  owner:      { type: 'String' },
  start:      { type: 'Date' },      // not String
  end:        { type: 'Date' },      // not String
  progress:   { type: 'Number' },
  dependsOn:  { type: 'Array' },     // not a comma-separated String
  milestone:  { type: 'Boolean' },
}
Datas como texto parecem bem até você compará-las. 2026-10-9 e 2026-10-09 são strings diferentes, ordenam de forma diferente, e nenhuma das duas se compara corretamente com uma data de verdade — então “o que está atrasado” devolve silenciosamente as linhas erradas em vez de falhar.
Dependências como texto têm o mesmo tipo de problema. "6,7" não pode ser pesquisado por pertencimento; como array, pode, e essa é toda a segunda metade deste post.
Como medimos: a classe foi criada com um POST /schemas/Activity e devolveu HTTP 200 em 3,1 segundos, reportando de volta os oito campos mais os quatro que o Parse acrescenta.
Como colocar doze linhas de uma vez?
Com uma requisição batch, não com doze idas e voltas. O endpoint de batch recebe uma lista de operações e as executa no servidor:
await fetch(`${PARSE}/batch`, {
  method: 'POST', headers: asServer,
  body: JSON.stringify({
    requests: rows.map((body) => ({ method: 'POST', path: '/classes/Activity', body })),
  }),
});
Isso importou todas as doze em 502 ms. Doze requisições separadas da mesma máquina custariam doze idas e voltas; esta custa uma.
Como medimos: um POST /batch carregando doze operações de criação, cronometrado em torno da chamada única, devolvendo doze objetos de sucesso.
O que está atrasado, e o que isso bloqueia?
Duas queries, e a segunda é a que uma planilha não faz por você. Atrasado é uma interseção direta — a data de fim passou e o trabalho não terminou:
{ "end": { "$lt": { "__type": "Date", "iso": "2026-10-09T00:00:00.000Z" } },
  "progress": { "$lt": 100 } }
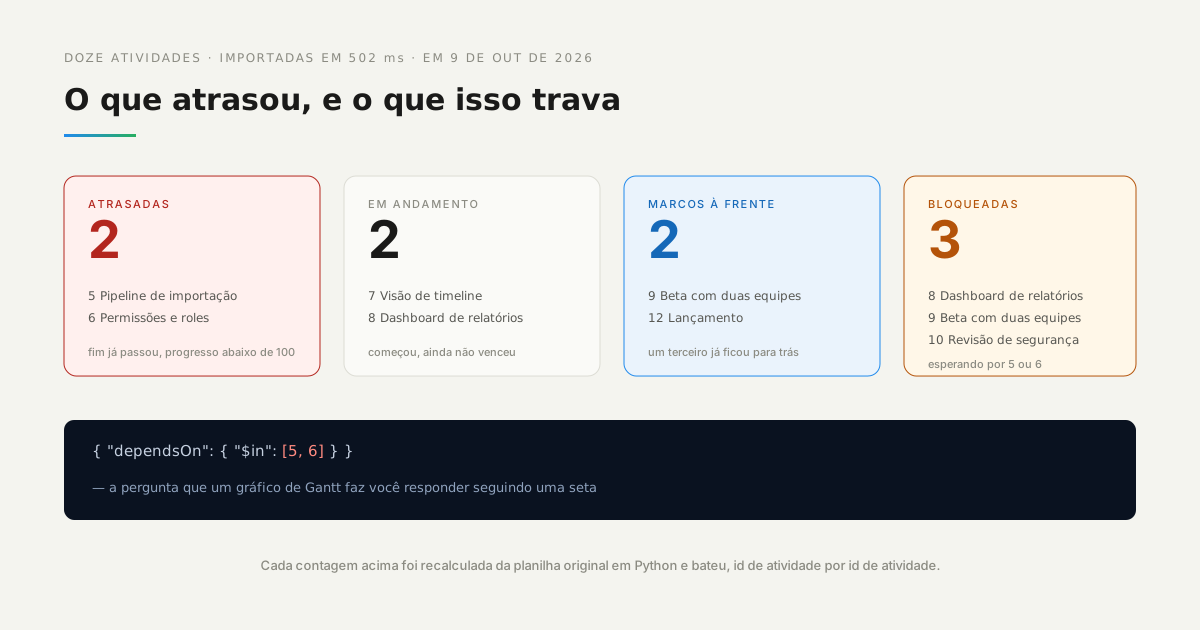
Em 9 de outubro, isso devolveu duas atividades: o pipeline de importação com 80% e as permissões com 45%. Quatro outras atividades tinham data de fim no passado e foram corretamente deixadas de fora, porque estavam concluídas.
Depois, a pergunta que o gráfico faz você rastrear à mão. Pegue os ids das atividades atrasadas e pergunte quais linhas dependem de qualquer uma delas:
{ "dependsOn": { "$in": [5, 6] } }Três atividades voltaram — a dashboard de relatórios, o beta e a revisão de segurança. Duas tarefas que atrasaram estão segurando três outras, e ninguém precisou seguir uma seta para descobrir.
O gráfico mostra a dependência. O array deixa você fazer uma pergunta a ela.
O que mais um tracker precisa responder?
Mais duas queries, as duas de uma linha, e junto com as duas primeiras elas cobrem a reunião de segunda-feira:
| Pergunta | A query | Em 9 de out |
|---|---|---|
| O que está atrasado? | end < today e progress < 100 | 2 — 466 ms |
| O que está rodando agora? | start <= today <= end | 2 — 278 ms |
| Quais marcos restam? | milestone = true e end >= today | 2 — 168 ms |
| O que está bloqueado? | dependsOn $in [late ids] | 3 — 170 ms |
Como medimos: cada query cronometrada individualmente contra a classe importada, já aquecida, de um laptop para a região USA East. A primeira é mais lenta porque é a primeira — a conexão está fria.
Essas respostas estão certas?
Estão, e vale conferir em vez de presumir. As mesmas quatro perguntas foram recalculadas a partir do CSV original em Python, sem nenhum banco de dados envolvido:
                  from the database      from the spreadsheet
late              2  [5, 6]              2  [5, 6]
in flight         2  [7, 8]              2  [7, 8]
milestones ahead  2  [9, 12]             2  [9, 12]
blocked           3  [8, 9, 10]          3  [8, 9, 10]
Idênticas, incluindo os ids exatos das atividades. A linha interessante é a terceira: um marco de aprovação da arquitetura em 16 de setembro está corretamente ausente das duas, porque ficou para trás — uma query que contasse todos os marcos teria dito três, e seria inútil.
Como medimos: o verify.py do repositório companion lê activities.csv e aplica as mesmas quatro regras em Python puro; os números do banco vêm da execução acima.
Quais erros você vai encontrar ao importar um cronograma?
Três, e o primeiro é o que custa uma tarde.
| O que você vê | O que significa |
|---|---|
{"code":107,"error":"cannot route POST /parse/classes/Activity"} | o caminho do batch carrega um prefixo /parse que não deveria |
As datas importam, mas $lt devolve tudo ou nada | a coluna é String; recrie como Date e importe de novo |
Queries em dependsOn não devolvem nada com $in | a coluna é uma String como "6,7", não um array |
Nenhum dos três é um erro de validação, e é isso que os torna lentos de achar: a importação tem sucesso, os dados parecem certos no Database Browser, e só as queries se comportam de forma estranha. Se uma comparação de datas devolve um número que você não consegue explicar, verifique o tipo da coluna antes de verificar a query.
Quando a planilha ainda é a ferramenta melhor?
Enquanto o plano ainda está mudando de forma. Arrastar uma barra é mais rápido que uma migração, e um cronograma que ainda está em discussão não se beneficia de um schema — a folga é o recurso.
Também não há problema em ficar na planilha quando ninguém mais a lê. O caso para migrar é várias pessoas fazendo perguntas diferentes ao mesmo plano ao mesmo tempo; para uma pessoa com uma visão só, o gráfico já é a resposta.
E se o que você precisa é a imagem, e não as perguntas, fique com o gráfico. Nada aqui desenha um Gantt — responde a queries sobre um. Um tracker que não consegue mostrar as barras vai perder para uma planilha que consegue, por melhor que seja o seu modelo de dados.
O que você acrescentaria ao tracker de cronograma em seguida?
Um par de datas baseline ao lado das datas vivas. Toda linha aqui tem um início e um fim, o que significa que o cronograma pode atrasar sem deixar rastro do que foi prometido — e “estamos atrasados?” é uma pergunta diferente de “isso algum dia teve chance?”.
Depois disso, a cadeia de dependências em vez de um salto só. A query de bloqueio encontra o que espera diretamente por uma tarefa atrasada; ela não segue a cadeia até a data de lançamento três passos adiante. Isso é uma função de Cloud Code percorrendo dependsOn recursivamente, e é o ponto em que o tracker começa a dizer algo que a planilha nunca conseguiria.