Seu app precisa de uma foto de perfil, ou de uma foto em cada anúncio, e o primeiro resultado da busca diz: crie um bucket, escreva uma política de IAM, gere uma URL pré-assinada num servidor, depois faça o upload do navegador para o bucket e grave a chave de volta no seu banco de dados. Quatro peças móveis para um <input type="file">.
Um backend gerenciado tem um endpoint de arquivos: você faz um POST dos bytes brutos para /files/<nome> com um Content-Type, e a resposta é uma URL pública servida por uma CDN; uma linha no seu banco referencia o arquivo pelo nome. Sem bucket, sem política, sem URL assinada, sem serviço de upload próprio e nada para rodar sem gerenciar um servidor.
Construímos isso como uma página HTML com 120 linhas de JavaScript, mais um script curl que mede tudo o que a página não consegue dizer: quão grande, quão rápido, quem pode fazer upload, quem pode ler e o que acontece com os bytes quando a linha some. Tudo abaixo foi medido em 24 de setembro de 2026, incluindo o arquivo apagado que a CDN continuou servindo.
Pegue o código funcionando: o repositório companion está em github.com/templates-back4app/image-upload-starter — web/, cloud/main.js, upload-check.sh, hook-check.sh e web-check.mjs. Rode o script contra o seu backend e você obtém todas as tabelas deste post com os seus próprios números.
O que é um upload de arquivo num backend gerenciado, e como é a URL?
Um upload de arquivo é uma requisição HTTP: POST /files/<nome> com os bytes do arquivo como corpo, o tipo MIME em Content-Type, os mesmos dois headers de app que toda outra chamada leva, mais o session token do usuário. O backend guarda os bytes num object store atrás de uma CDN e responde 201 com duas coisas, um name e uma url.
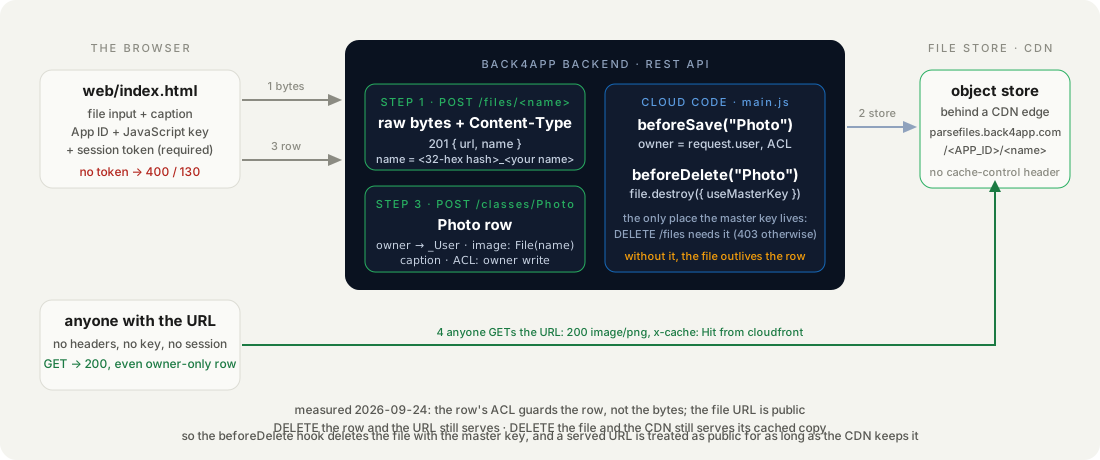
Esta é a troca inteira, de upload-check.sh, com o App ID substituído:
# Stack: bash + curl | File: upload-check.sh (step 1)
curl -s -w '  %{http_code}\n' -H "X-Parse-Application-Id: $APP_ID" -H "X-Parse-JavaScript-Key: $JS_KEY" \
  -H "X-Parse-Session-Token: $SESSION_TOKEN" -H "Content-Type: image/png" \
  -X POST "https://parseapi.back4app.com/files/user.png" --data-binary @user.png
{"url":"https://parsefiles.back4app.com/<APP_ID>/70294a8c55322f2b8fa059066317d0a3_user.png","name":"70294a8c55322f2b8fa059066317d0a3_user.png"} 201Três coisas a ler nessa linha. O name é o nome do seu arquivo atrás de um hash de 32 caracteres: dois usuários enviando avatar.png nunca colidem, e ninguém adivinha uma URL a partir de um nome.
A url fica num host diferente do da API, parsefiles.back4app.com, e seu primeiro segmento de caminho é o App ID, que é uma chave de cliente e já vai na sua página de qualquer jeito.
E não há expiração, assinatura nem token nela: quem tem a URL tem o arquivo.
A URL é a credencial. Não há mais nada a verificar, então não há mais nada a vazar.
Buscamos um upload de 1 MB sem header nenhum. 200, content-type: image/png, content-length: 999762, server: AmazonS3, via: … cloudfront.net, x-cache: Miss from cloudfront nas duas primeiras requisições, de edge nodes diferentes, e Hit from cloudfront da terceira em diante.
Com um header Origin a resposta acrescentou access-control-allow-origin: *, então fetch() e <canvas> funcionam cross-origin, e uma requisição Range: bytes=0-99 recebeu 206. Nenhum header cache-control, o que importa mais adiante.
Como fazer upload de uma imagem de uma página web em JavaScript puro?
Com fetch, enviando o próprio objeto File como corpo. O navegador define o tamanho; você define o Content-Type a partir de file.type. Não há SDK na página nem codificação de formulário: o corpo são os bytes. Aqui estão o helper e a função de upload de web/app.js:
// Stack: vanilla JavaScript (browser) | File: web/app.js
const BASE = window.BACKEND_URL ?? "https://parseapi.back4app.com";
const HEADERS = {
  "X-Parse-Application-Id": window.APP_ID,
  "X-Parse-JavaScript-Key": window.JS_KEY,      // a client key: identifies the app, not the user
  "X-Parse-Revocable-Session": "1",
};

// One helper for every call. `body` is a plain object (sent as JSON) or a File/Blob (sent as raw bytes with its type).
async function api(method, path, body) {
  const headers = { ...HEADERS };
  const token = session.get();                                    // sessionStorage; uploads without it get code 130
  if (token) headers["X-Parse-Session-Token"] = token;
  let payload;
  if (body instanceof Blob) { headers["Content-Type"] = body.type || "application/octet-stream"; payload = body; }
  else if (body) { headers["Content-Type"] = "application/json"; payload = JSON.stringify(body); }
  const r = await fetch(BASE + path, { method, headers, body: payload });
  const data = await r.json().catch(() => ({}));
  if (!r.ok) throw Object.assign(new Error(data.error ?? r.statusText), { code: data.code, status: r.status });
  return data;
}

// Step 1: the bytes. POST /files/<name> answers 201 {url, name}.
async function uploadFile(file) {
  const safeName = file.name.replace(/[^\w.]+/g, "-");            // the path segment; the served name gets a hash prefix
  return api("POST", `/files/${encodeURIComponent(safeName)}`, file);
}
A página tem um formulário de cadastro/login acima do input de arquivo por um motivo que não planejamos: o primeiro upload que tentamos, só com o App ID e a JavaScript key, foi recusado. 400, código 130, File upload by public is disabled.
Os mesmos bytes com um session token: 201. Com a master key: 201. Então a página faz o login do usuário, guarda o token em sessionStorage e só então mostra o input.
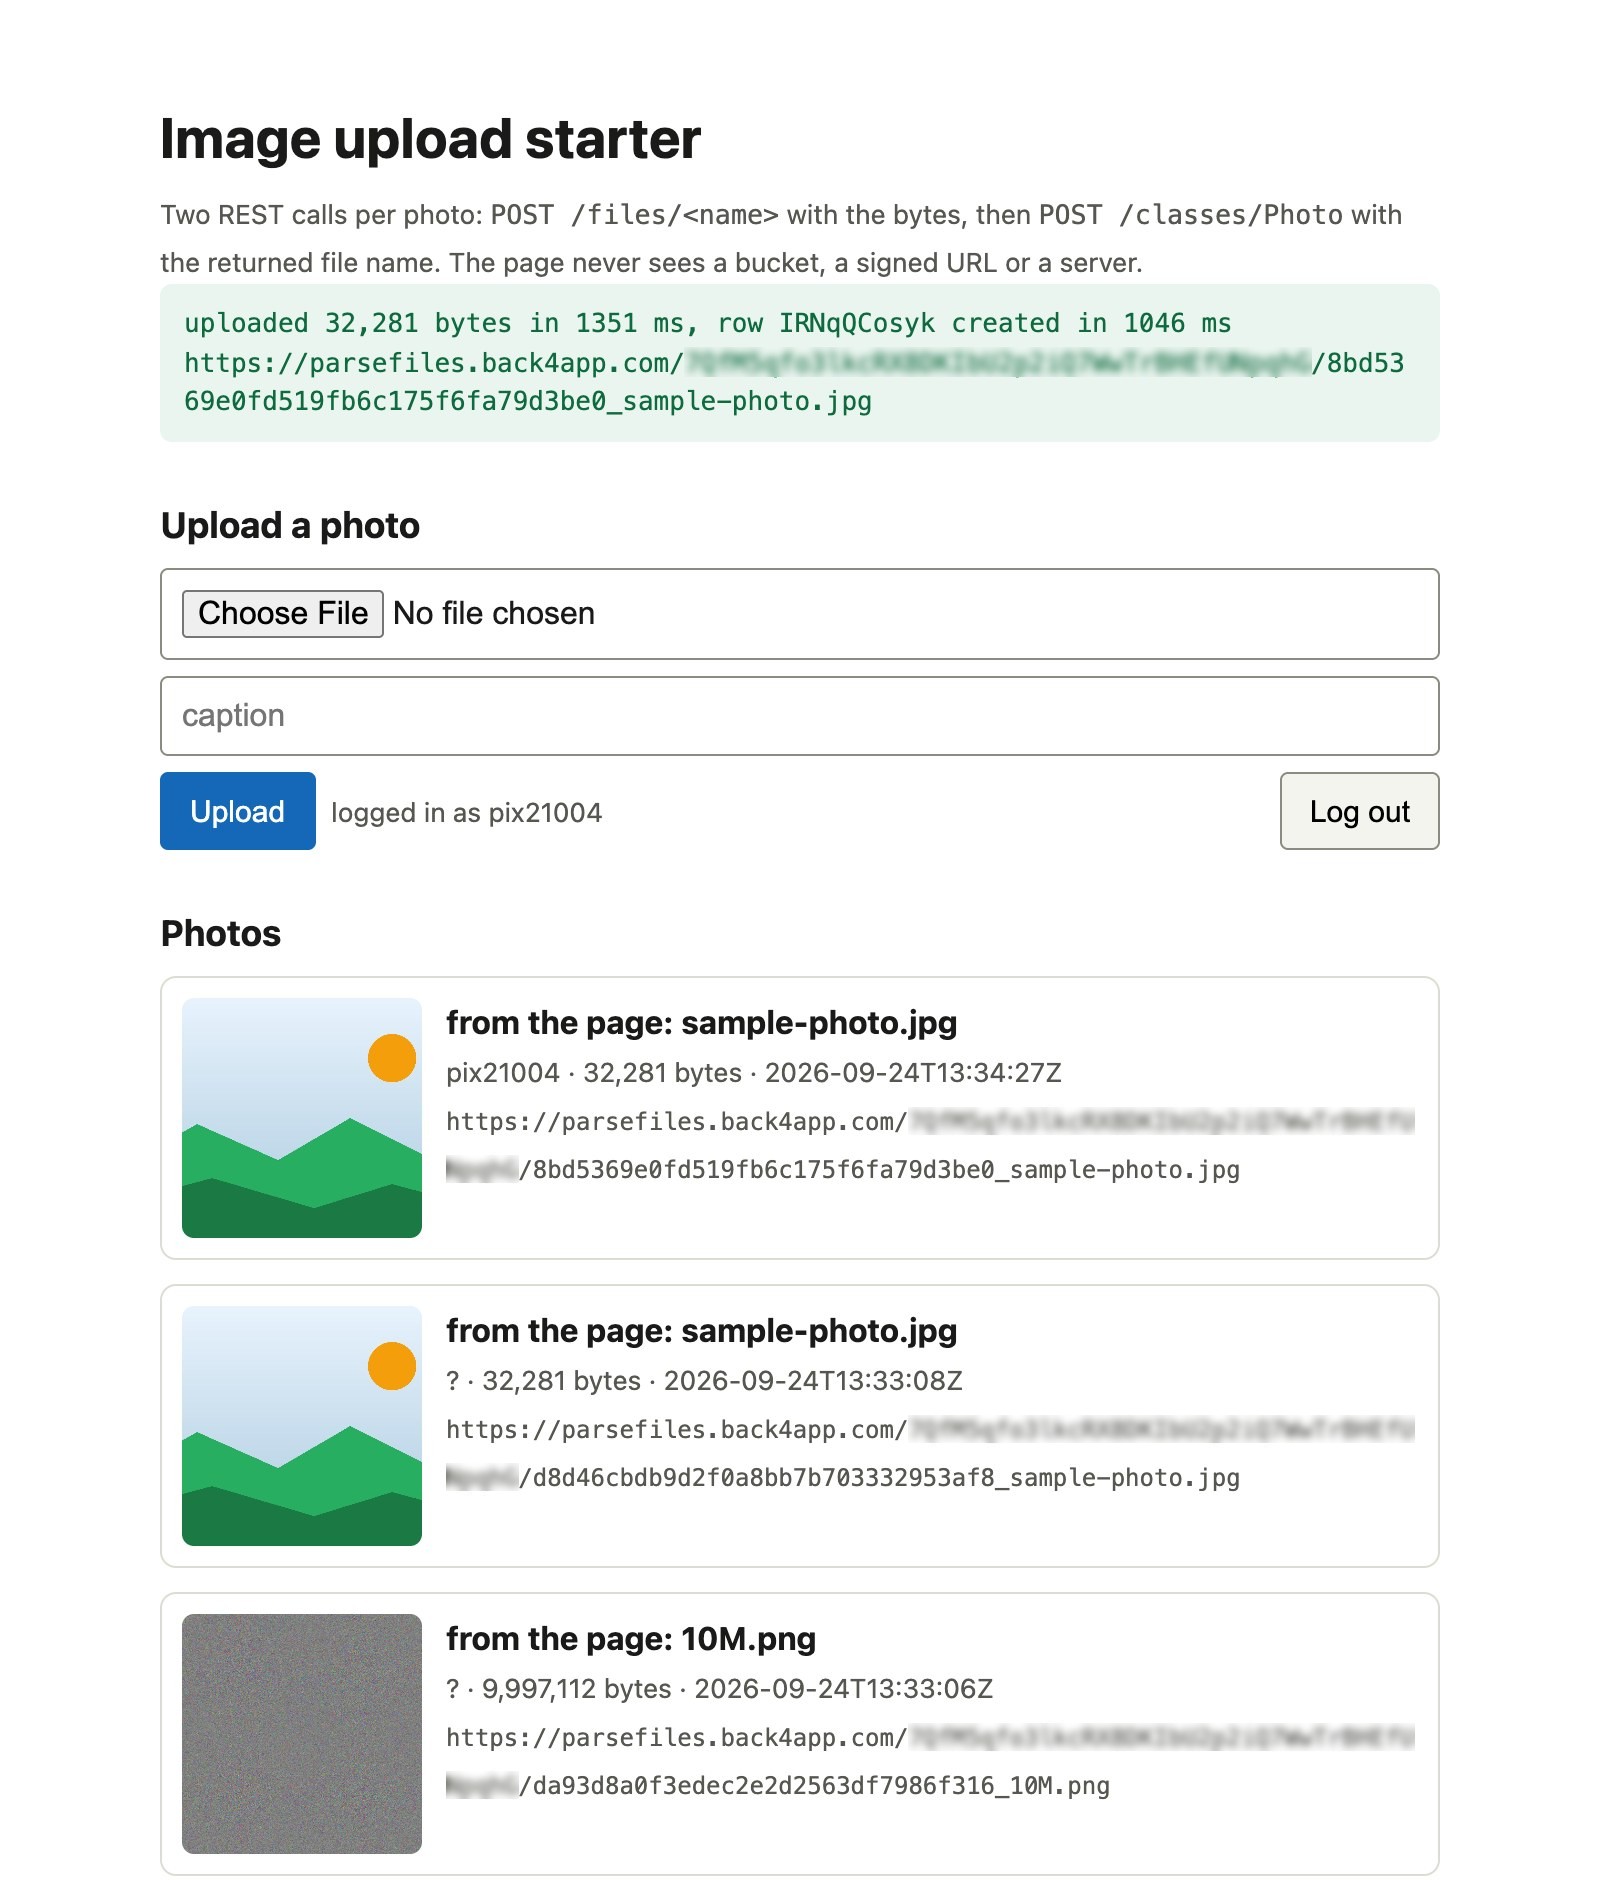
O handler de submit envolve as duas chamadas em performance.now() e imprime os dois tempos na barra de status, que é de onde vêm os números de navegador deste post:
// Stack: vanilla JavaScript (browser) | File: web/app.js (upload handler)
$("#upload").addEventListener("submit", async (e) => {
  e.preventDefault();
  const file = e.target.file.files[0];
  const caption = e.target.caption.value.trim();
  if (!file) return;
  try {
    status(`uploading ${file.name} (${fmt(file.size)} bytes)…`);
    const t0 = performance.now();
    const stored = await uploadFile(file);                    // 201 {url, name}
    const t1 = performance.now();
    const photo = await createPhoto(stored, caption, file);   // 201 {objectId, createdAt}
    const t2 = performance.now();
    status(`uploaded ${fmt(file.size)} bytes in ${Math.round(t1 - t0)} ms, row ${photo.objectId} created in ${Math.round(t2 - t1)} ms\n${stored.url}`, "ok");
    e.target.reset(); await listPhotos();
  } catch (err) { status(`${err.code ?? err.status} ${err.message}`, "err"); }
});
Dirigimos a página em Chrome headless com web-check.mjs, que cria a conta, coloca um arquivo real no input pelo protocolo do DevTools e clica no botão, então os tempos são da própria página.
Os números da página acompanham os do curl com menos de um segundo de diferença em todo tamanho: 1,21 s para 10 KB, 1,68 s para 100 KB, 6,84 s para 1 MB, 28,6 s para 5 MB e 54,8 s para 10 MB, com o POST da linha depois entre 0,7 s e 2,2 s. A barra de status imprime os dois e a URL completa.
Como vincular o arquivo a uma linha Photo e ao seu dono?
Com um segundo POST, para /classes/Photo, cujo campo image é um valor File: { "__type": "File", "name": "<o name do passo 1>", "url": "<a url do passo 1>" }. O backend resolve o nome para a URL sempre que você lê a linha de volta; a url na requisição está lá porque o backend precisa dela assim que um trigger roda na classe, como medido abaixo.
owner é um pointer para o usuário logado, e a ACL diz quem pode alterar a linha:
// Stack: vanilla JavaScript (browser) | File: web/app.js (the row)
// Step 2: the row. A File field references the stored file by name. Send the url from step 1 as well (see the finding
// in the deletion section: with a trigger on the class, name alone answered 502).
async function createPhoto({ name, url }, caption, file) {
  return api("POST", "/classes/Photo", {
    caption,
    image: { __type: "File", name, url },
    contentType: file.type,
    size: file.size,
    owner: { __type: "Pointer", className: "_User", objectId: me.objectId },
    ACL: { "*": { read: true }, [me.objectId]: { read: true, write: true } },
  });
}
Listar é um GET /classes/Photo?order=-createdAt&include=owner, e cada resultado traz image: { __type: "File", name, url }. A página coloca a url num <img src>; a CDN faz o resto.
Não definimos a classe nem nenhuma coluna à mão: o primeiro POST criou Photo com caption, image, contentType, size e owner, tipados a partir dos valores que enviamos.
Uma coisa que a captura mostra e o código não pretendia: quem enviou aparece como ? nas fotos de outros usuários. include=owner expande o pointer só quando quem chama pode ler a linha daquele usuário, e neste backend um usuário lendo a linha de outro recebeu 404 / 101, com session token ou sem.
Se o nome importa, guarde-o na linha Photo como string na hora do upload.
Duas decisões estão embutidas nessa ACL, e as duas pertencem ao backend, não à página. Um comando curl pode enviar qualquer owner e qualquer ACL que quiser com a mesma chave de cliente.
O cloud/main.js do repositório tem um beforeSave("Photo") que sobrescreve os dois a partir de request.user, exatamente como a classe Note faz no post sobre travar o backend. A seção sobre exclusão, abaixo, diz o que ele faz e o que aconteceu quando fizemos o deploy.
Qual o tamanho máximo de um arquivo, e quanto tempo leva um upload?
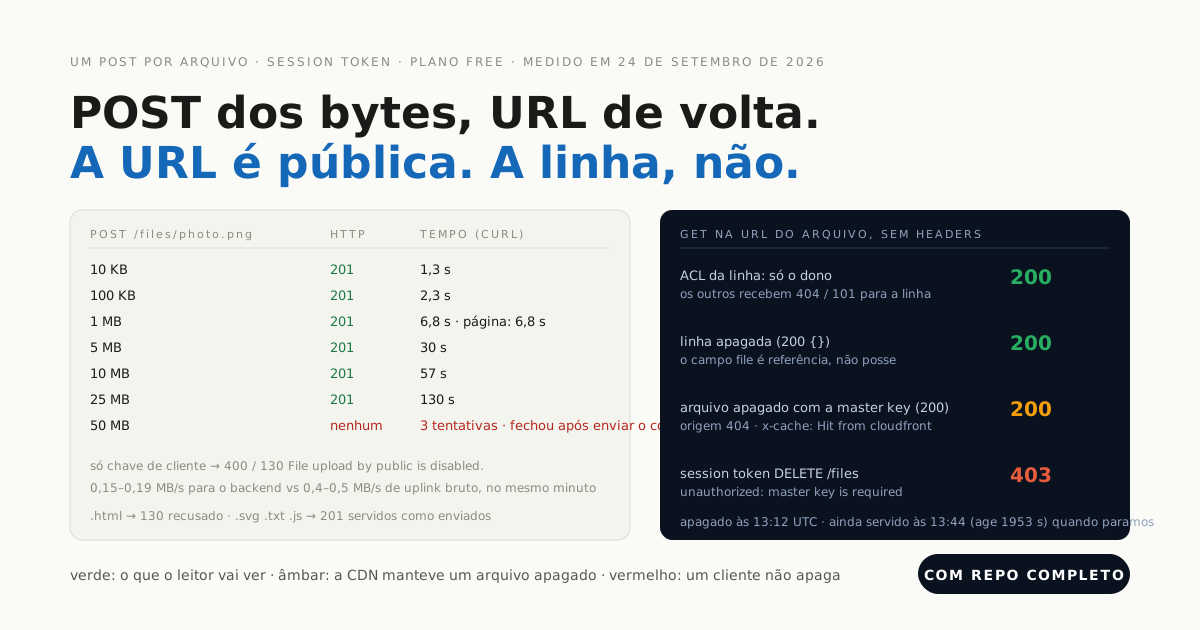
Maior do que esperávamos, e mais lento que a conexão. Geramos PNGs reais de seis tamanhos (pixels aleatórios, armazenados sem compressão, para que a contagem de bytes fosse a que pedimos) e enviamos cada um com um POST do curl, session token, Content-Type: image/png. Todos devolveram 201:
| Tamanho (bytes enviados) | HTTP | Tempo, curl (mediana de 3, intervalo) | Tempo, página web | POST da linha depois |
|---|---|---|---|---|
| 10 KB (9.872) | 201 | 1,33 s (1,21–1,38) | 1,21 s | 1,10 s |
| 100 KB (99.649) | 201 | 2,33 s (2,06–3,08) | 1,68 s | 2,05 s |
| 1 MB (999.762) | 201 | 6,78 s (6,77–7,18) | 6,84 s | 0,72 s |
| 5 MB (4.995.285) | 201 | 29,5 s (27,8–31,5) | 28,6 s | 0,71 s |
| 10 MB (9.997.112) | 201 | 56,6 s (53,2–65,5) | 54,8 s | 2,17 s |
| 25 MB (24.998.119) | 201 | 130 s (uma rodada) | – | – |
| 50 MB (50.008.266) | nenhum | 200–329 s, depois a conexão fechou, 3 de 3 | – | – |
Como medimos: curl -w '%{time_total} %{speed_upload}' em volta de cada POST, do primeiro byte da requisição ao último byte do 201, a mediana de três rodadas por tamanho de 10 KB a 10 MB (iniciadas às 13:08, 13:39 e 13:41 UTC) e uma rodada para 25 MB (13:09 UTC), de um laptop para o backend em USA East, plano Free, em 24 de setembro de 2026.
A coluna do navegador é performance.now() em volta de cada fetch em web/app.js, uma rodada por tamanho às 13:31–13:33 UTC, lida da barra de status da página por web-check.mjs em Chrome 154 headless.
Os tempos absolutos são do nosso uplink. Nos mesmos minutos, o mesmo arquivo de 10 MB foi para dois endpoints de teste de banda sem relação a 0,49 MB/s e 0,38 MB/s, contra 0,15 a 0,19 MB/s para o backend.
O arquivo de 50 MB é a única linha sem status. Duas vezes sobre HTTP/2 o curl reportou Error in the HTTP2 framing layer após 321 s e 329 s; uma vez sobre HTTP/1.1 recebeu 100 Continue, enviou tudo e após 200 s recebeu Empty reply from server. Todos os 50.008.266 bytes saíram do laptop a cada vez.
Isso é um limite entre 25 e 50 MB ou um timeout de requisição de alguns minutos; o backend não disse qual, então nós também não.
Então, nesta conexão, o caminho de upload rodou a cerca de metade do link bruto, o que é consistente com o backend receber o corpo inteiro antes de gravá-lo no store e responder. Reserve mais ou menos o dobro do que um upload simples dos mesmos bytes levaria, e mostre progresso.
Quem pode ler a URL do arquivo quando a linha é só do dono?
Todo mundo. Essa era a medição que mais queríamos, e a resposta é simples: a ACL protege a linha, e a URL não é a linha. Criamos um Photo cuja ACL concedia leitura e escrita só ao dono, referenciando o arquivo de 1 MB, e pedimos por ele de três jeitos:
| Requisição | Resposta |
|---|---|
anônimo (App ID + JavaScript key) → GET /classes/Photo/2VU6ud9qUs | 404 {"code":101,"error":"Object not found."} |
dono (session token) → GET /classes/Photo/2VU6ud9qUs | 200 |
qualquer um, sem header nenhum → GET <a URL do arquivo> | 200 image/png 999762 bytes |
A linha se esconde. O arquivo não, porque a requisição pelo arquivo nunca chega ao backend: ela vai para a CDN, que não sabe nada de _User, sessões ou ACLs. Nada nesse caminho pode ser instruído a verificar coisa alguma.
Isso também decide o que vai no arquivo. Enviamos um .txt, um .svg, um .js e um blob sem nome e sem Content-Type nenhum; os quatro voltaram 201, e cada URL serviu exatamente o tipo que enviamos. Um PNG enviado como image/jpeg foi servido como image/jpeg. Nada inspecionou os bytes.
A única recusa foi .html: 130 File upload of extension html is disabled., que é o backend impedindo que uma página com o seu App ID na URL hospede o script de outra pessoa.
O que acontece com o arquivo quando você apaga a linha?
Nada. Esse é o achado que moldou o resto do repositório. O dono apagou a linha Photo, 200 {}, e dois segundos depois a URL do arquivo ainda respondia 200 image/png 999762 bytes. A linha e o arquivo são dois objetos com duas vidas, e o campo File é uma referência, não posse.
Então tentamos apagar o arquivo. DELETE /files/<nome> com o session token: 403 {"error":"unauthorized: master key is required"}. Com a JavaScript key: o mesmo 403. Com a master key: 200. Depois a URL de novo, dois segundos mais tarde: 200, o arquivo inteiro. Dez segundos depois: 200.
O caminho de origem no host da API, GET /files/<APP_ID>/<nome>, dizia 404; a URL pública dizia x-cache: Hit from cloudfront e um age que não parava de subir. Continuamos consultando a cada dois minutos.
Às 13:44 UTC, 32 minutos após o delete, a URL ainda devolvia 200 com age: 1953, e continuava assim quando paramos de observar.
| Passo | Resposta |
|---|---|
dono → DELETE /classes/Photo/<id> | 200 {} |
GET <URL do arquivo> 2 s depois | 200 image/png, todos os bytes |
session token → DELETE /files/<nome> | 403 unauthorized: master key is required |
JavaScript key → DELETE /files/<nome> | 403 unauthorized: master key is required |
master key → DELETE /files/<nome> | 200 |
GET /files/<APP_ID>/<nome> no host da API | 404 |
GET <URL do arquivo> (CDN), 2 s / 10 s / 32 min depois | 200, x-cache: Hit from cloudfront, age subindo |
GET <URL do arquivo>?v=2 | 200, a mesma cópia em cache |
Como medimos: upload-check.sh, passos 7 e 8, uma rodada às 13:12 UTC em 24 de setembro de 2026, depois um poller buscando a URL apagada a cada dois minutos e registrando o status e os headers x-cache e age, de um laptop por um edge da CDN (o header x-amz-cf-pop dizia MIA50).
Duas consequências. Um cliente não consegue apagar um arquivo, então “remover minha foto” tem que rodar no backend. E “apagado” significa que a origem esqueceu o objeto enquanto o edge continua servindo, sem header cache-control para encurtar isso e sem query string para invalidar: a requisição ?v=2 foi um hit na mesma cópia.
Se o arquivo foi enviado por engano, conte com ele continuar acessível a partir desse edge por um tempo depois de você apagá-lo.
Como fazer uma linha apagada levar o arquivo junto?
Com um hook beforeDelete em Photo no Cloud Code, que é o único lugar que pode guardar a master key. Ele roda no backend para todo delete, seja qual for o cliente que pediu, lê o campo image e destrói o arquivo antes de a linha sumir:
// Stack: Node.js 22.x | Parse Server 7.x (Cloud Code) | File: cloud/main.js
// Rule 1: a Photo belongs to whoever uploaded it, whatever the client claimed. Anyone may read the row; only the owner
// may change or delete it. Set here, on the backend, so a curl command cannot skip it.
Parse.Cloud.beforeSave("Photo", (request) => {
  const photo = request.object;
  if (!photo.isNew()) return;
  const owner = request.user;
  if (!owner) throw new Parse.Error(Parse.Error.SESSION_MISSING, "log in to upload a photo.");
  if (!photo.get("image")) throw new Parse.Error(Parse.Error.VALIDATION_ERROR, "a Photo needs an image.");
  photo.set("owner", owner);
  const acl = new Parse.ACL();
  acl.setPublicReadAccess(true);
  acl.setWriteAccess(owner, true);
  photo.setACL(acl);
});

// Rule 2: deleting the row deletes the file. DELETE /files/<name> needs the master key, which lives here and nowhere else.
Parse.Cloud.beforeDelete("Photo", async (request) => {
  const file = request.object.get("image");
  if (!file) return;
  try {
    await file.destroy({ useMasterKey: true });
  } catch (err) {
    // A file that is already gone must not block the row delete; anything else should.
    if (err.code !== Parse.Error.FILE_DELETE_ERROR && err.code !== Parse.Error.OBJECT_NOT_FOUND) throw err;
  }
});
file.destroy({ useMasterKey: true }) é o mesmo DELETE /files/<nome> que enviamos do terminal, emitido de dentro do backend com a chave que o cliente nunca teve.
O beforeSave acima dele é a outra metade: owner e a ACL vêm de request.user, então os valores da própria página são sobrescritos e um comando curl não consegue reivindicar a conta de outra pessoa.
O deploy do Cloud Code é feito pela dashboard (Cloud Code → main.js → Deploy, duas vezes num backend novo: o primeiro deploy não envia nada, um comportamento que já vimos em sete backends antes deste).
O hook-check.sh do repositório é a prova: dois usuários, um upload, uma linha criada de propósito com o owner errado e uma ACL aberta, depois o delete pelo dono e um GET do caminho de origem do arquivo, que precisa ser 404.
Esta é a rodada, às 14:38 UTC de 24 de setembro de 2026, com o arquivo no ar. ana fez o upload, depois criou uma linha que alegava owner = bob e uma ACL de escrita pública.
A linha voltou com owner = ana e ACL {"*":{"read":true},"<ana>":{"write":true}}: a alegação do cliente foi sobrescrita. Depois ela a apagou, segurando nada além do seu session token:
| Passo | Resposta |
|---|---|
anônimo → POST /classes/Photo com uma imagem | 400 {"code":206,"error":"log in to upload a photo."} |
ana → POST /classes/Photo, corpo alega owner: bob, ACL: {"*": read+write} | 201, gravado owner: ana, ACL {"*":{"read":true},"ana":{"write":true}} |
bob → PUT / DELETE nessa linha | 404 / 101 Object not found. / Object not found for delete. |
ana → POST /classes/Photo sem imagem | 400 / 142 a Photo needs an image. |
| antes do delete: caminho de origem / URL da CDN | 200 / 200 image/png |
ana → DELETE /classes/Photo/sSo3LhjDmY | 200 {} |
2 s e 12 s depois: caminho de origem GET /files/<APP_ID>/<nome> | 404 |
| 2 s e 12 s depois: URL da CDN | 403, x-cache: Error from cloudfront |
Como medimos: hook-check.sh, uma rodada às 14:38:05–14:38:39 UTC em 24 de setembro de 2026, dois usuários novos, curl de um laptop; depois um delete com a master key às 14:39 de uma linha que a página tinha criado antes de o hook existir, que também devolveu 200 e deixou o caminho de origem em 404.
A linha da CDN difere do achado anterior, e a diferença é instrutiva. Este arquivo tinha sido buscado uma vez pela CDN antes do delete (x-cache: Miss), e depois do delete o edge respondeu 403 de imediato.
O arquivo de 1 MB da manhã tinha sido buscado várias vezes (Hit), e sua cópia em cache continuou servindo por 32 minutos depois do delete. O que o edge já guarda, ele mantém; o que ele não armazenou, ele vai buscar na origem.
A mesma requisição com a url da resposta do upload respondeu 400 / 206 ou 201 como deveria, e o mesmo valeu para um corpo sem image nenhum.
Antes de o trigger existir, name sozinho tinha funcionado a manhã inteira: a página e o script criaram toda linha desse jeito. Envie name e url, exatamente como o upload respondeu; a página e os dois scripts agora fazem isso.
O achado explica um trecho feio que temos de assumir. Por cerca de dez minutos depois do deploy do Cloud Code (14:11–14:24 UTC) o app reiniciou repetidamente e toda escrita em Photo respondeu 502.
Enquanto isso, o System log da dashboard mostrava os restarts e o Error log não mostrava nada além das nossas próprias entradas 142.
Nosso primeiro script de prova enviou name sozinho, trinta vezes, e cada tentativa reiniciou o app; se foi o deploy que começou ou as nossas repetições, não sabemos dizer.
Quais erros de upload você vai encontrar, e o que dizem seus corpos?
Toda recusa que encontramos em 24 de setembro de 2026 veio como um status HTTP mais um corpo JSON; decida pelo code, e pelo texto de error nos dois que compartilham 130:
| O que você fez | HTTP | code | error |
|---|---|---|---|
POST /files/<nome> só com o App ID e uma chave de cliente | 400 | 130 | File upload by public is disabled. |
POST /files/probe.html (session token) | 400 | 130 | File upload of extension html is disabled. |
DELETE /files/<nome> com um session token ou chave de cliente | 403 | – | unauthorized: master key is required |
GET /classes/Photo/<id> de uma linha que a sua ACL não pode ler | 404 | 101 | Object not found. |
GET /files/<APP_ID>/<nome> no host da API depois de o arquivo ser apagado | 404 | – | Not Found (texto puro) |
GET /files com a master key (não existe endpoint de listagem) | 404 | – | {"message":"Not Found","error":{}} |
POST /classes/Photo com image: {"__type":"File","name":…} e sem url, quando já existe um trigger na classe | 502 | – | Bad Gateway (texto puro), depois /health 502 por um segundo |
POST /classes/Photo sem sessão, hook no ar | 400 | 206 | log in to upload a photo. |
POST /classes/Photo sem image, hook no ar | 400 | 142 | a Photo needs an image. |
130 File upload by public is disabled. é o que o seu formulário vai encontrar primeiro. A correção é uma sessão, não uma chave: crie a conta do usuário ou faça o login, envie X-Parse-Session-Token com o POST e mantenha a master key fora da página. O starter só mostra o input de arquivo depois que GET /users/me aceitou o token.
130 File upload of extension html is disabled. é por nome, não por tipo: os mesmos bytes como probe.txt com Content-Type: text/html foram aceitos. Renomeie ou recuse na página, e não espere que o backend rejeite um script pelo conteúdo: probe.js passou como text/javascript.
502 Bad Gateway num save de Photo, com o app brevemente sem saúde depois, é o caso do File sem url da seção de exclusão. Envie {"__type":"File","name","url"} exatamente como o upload respondeu, e nunca repita um 502 em loop: cada um reinicia o app.
Um 201 com o Content-Type errado é o erro que você não vai ver. A URL serve o tipo que você enviou, então leia file.type do objeto File e recuse qualquer coisa que não seja image/* na página antes do upload, que é o que o accept="image/*" do input faz para um humano e uma verificação de duas linhas faz para um script.
Quando você quer object storage, afinal?
Quando o arquivo é o produto, ou a URL precisa expirar. Três casos em que um bucket que você administra, ou um serviço de arquivos dedicado, vence o endpoint de arquivos:
- Arquivos muito grandes. Nosso upload de 25 MB levou 130 s numa única requisição, num link lento, sem retomada, e 50 MB nunca recebeu resposta. Vídeo, fotos raw e exportações pedem uploads multipart, retomáveis, com progresso por parte, que a API de um bucket e uma biblioteca de cliente no navegador dão e um único
POSTnão dá. - URLs assinadas, com expiração. Um arquivo aqui é público até ser apagado, e fica em cache além disso. Downloads pagos, imagens médicas, contratos, qualquer coisa em que a URL precise parar de funcionar num momento que você escolhe, precisam de URLs assinadas com expiração, o que significa um object store e um servidor ou função que assine.
- Transformações na hora. Thumbnails, redimensionamento, conversão de formato, marcas d’água: uma CDN de imagens faz isso a partir de um parâmetro na URL. Aqui você envia os tamanhos de que precisa (a página pode redimensionar num
<canvas>antes doPOST) e referencia cada um a partir da linha.
Para avatares, fotos de anúncios, anexos e qualquer coisa que um usuário aceite ter numa URL pública, as duas chamadas acima são o recurso inteiro, e a parte que é sua são 32 linhas de Cloud Code.
O que você acrescentaria ao image upload starter em seguida?
- Redimensionar no navegador. Desenhe a imagem num
<canvas>a 1600 px,toBlob("image/webp", 0.85), e envie isso: nossa foto de celular de 5 MB vira um upload de 300 KB, e a tabela de tempos acima encolhe junto. - Progresso.
fetchnão consegue reportar progresso de upload;XMLHttpRequestconsegue. TroqueuploadFilepor uma versão comxhr.upload.onprogresse mostre uma barra, que os 57 s para 10 MB justificam. - Um job de limpeza. Arquivos enviados cuja criação de linha falhou (o segundo
POSTpode falhar depois de o primeiro ter sucesso) são órfãos que ninguém referencia. Um Cloud Job agendado que lista as linhasPhotoe apaga os arquivos não referenciados com a master key mantém o 1 GB honesto. - Arquivos privados. Uma classe
Documentcom ACL só do dono e uma Cloud Functiondownload(id)que verificarequest.usere devolve os bytes com a master key: o padrão do contra-caso, neste backend. - Usuários primeiro, permissões em seguida. A página precisa de contas porque uploads exigem uma sessão: esse é o post sobre autenticação. Quem pode ler e escrever as linhas
Photo, com uma sonda que você pode rodar de novo, é o post sobre travar o backend.