Tu app necesita una foto de perfil, o una foto en cada anuncio, y el primer resultado de búsqueda dice: crea un bucket, escribe una política de IAM, genera una URL prefirmada desde un servidor, sube desde el navegador al bucket y escribe la clave de vuelta en tu base de datos. Cuatro piezas móviles para un solo <input type="file">.
Un backend gestionado tiene un endpoint de archivos: haces POST con los bytes en bruto a /files/<name> con un Content-Type, y la respuesta es una URL pública servida a través de una CDN; una fila de tu base de datos referencia el archivo por nombre. Sin bucket, sin política, sin URL firmada, sin servicio de subida propio y sin ningún servidor que administrar.
Lo construimos como una página HTML con 120 líneas de JavaScript, más un script de curl que mide todo lo que la página no puede decirte: qué tamaño, qué velocidad, quién puede subir, quién puede leer y qué pasa con los bytes cuando la fila desaparece. Todo lo que sigue se midió el 24 de septiembre de 2026, incluido el archivo borrado que la CDN siguió sirviendo.
Consigue el código funcionando: el repositorio companion está en github.com/templates-back4app/image-upload-starter — web/, cloud/main.js, upload-check.sh, hook-check.sh y web-check.mjs. Ejecuta el script contra tu backend y tendrás todas las tablas de este post con tus propios números.
¿Qué es subir un archivo a un backend gestionado y cómo es la URL?
Subir un archivo es una sola solicitud HTTP: POST /files/<name> con los bytes del archivo como cuerpo, su tipo MIME en Content-Type y los mismos dos headers de app que lleva cualquier otra llamada, más el session token del usuario. El backend guarda los bytes en un almacén de objetos detrás de una CDN y responde 201 con dos cosas, un name y una url.
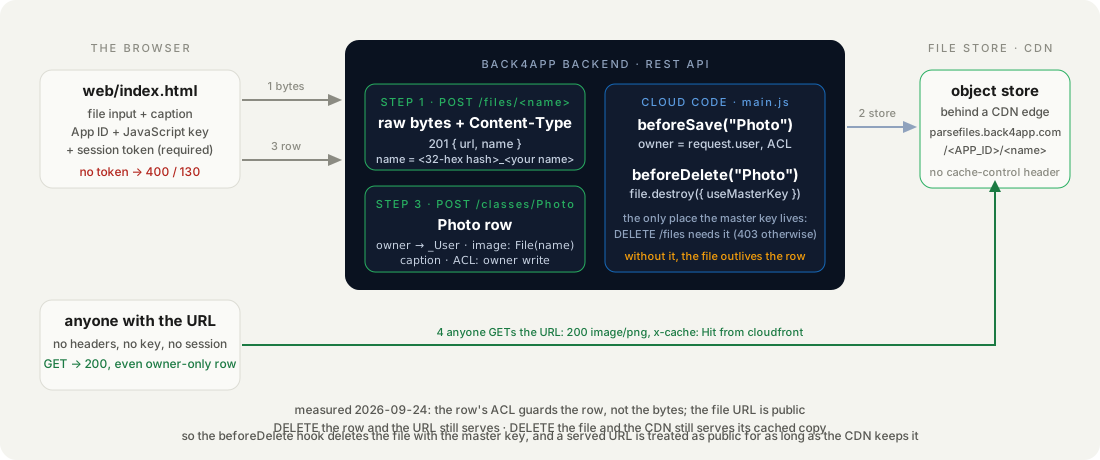
Este es el intercambio completo, sacado de upload-check.sh, con el App ID sustituido:
# Stack: bash + curl | File: upload-check.sh (step 1)
curl -s -w '  %{http_code}\n' -H "X-Parse-Application-Id: $APP_ID" -H "X-Parse-JavaScript-Key: $JS_KEY" \
  -H "X-Parse-Session-Token: $SESSION_TOKEN" -H "Content-Type: image/png" \
  -X POST "https://parseapi.back4app.com/files/user.png" --data-binary @user.png
{"url":"https://parsefiles.back4app.com/<APP_ID>/70294a8c55322f2b8fa059066317d0a3_user.png","name":"70294a8c55322f2b8fa059066317d0a3_user.png"} 201Tres cosas que leer en esa línea. El name es tu nombre de archivo detrás de un hash de 32 caracteres, así que dos usuarios que suban avatar.png nunca colisionan y nadie puede adivinar una URL a partir de un nombre.
La url está en un host distinto del de la API, parsefiles.back4app.com, y su primer segmento de ruta es el App ID, que es una clave de cliente y de todos modos va en tu página.
Y no hay caducidad, ni firma, ni token: quien tiene la URL tiene el archivo.
La URL es la credencial. No hay nada más que comprobar, así que no hay nada más que filtrar.
Descargamos una subida de 1 MB sin ningún header. 200, content-type: image/png, content-length: 999762, server: AmazonS3, via: … cloudfront.net, x-cache: Miss from cloudfront en las dos primeras solicitudes desde nodos edge distintos y Hit from cloudfront a partir de la tercera.
Con un header Origin la respuesta añadió access-control-allow-origin: *, así que fetch() y <canvas> funcionan entre orígenes, y una solicitud Range: bytes=0-99 obtuvo 206. Ningún header cache-control, lo que importará más adelante.
¿Cómo subes una imagen desde una página web en JavaScript vanilla?
Con fetch, enviando el propio objeto File como cuerpo. El navegador fija la longitud; tú fijas Content-Type a partir de file.type. No hay SDK en la página ni codificación de formulario: el cuerpo son los bytes. Este es el helper y la función de subida de web/app.js:
// Stack: vanilla JavaScript (browser) | File: web/app.js
const BASE = window.BACKEND_URL ?? "https://parseapi.back4app.com";
const HEADERS = {
  "X-Parse-Application-Id": window.APP_ID,
  "X-Parse-JavaScript-Key": window.JS_KEY,      // a client key: identifies the app, not the user
  "X-Parse-Revocable-Session": "1",
};

// One helper for every call. `body` is a plain object (sent as JSON) or a File/Blob (sent as raw bytes with its type).
async function api(method, path, body) {
  const headers = { ...HEADERS };
  const token = session.get();                                    // sessionStorage; uploads without it get code 130
  if (token) headers["X-Parse-Session-Token"] = token;
  let payload;
  if (body instanceof Blob) { headers["Content-Type"] = body.type || "application/octet-stream"; payload = body; }
  else if (body) { headers["Content-Type"] = "application/json"; payload = JSON.stringify(body); }
  const r = await fetch(BASE + path, { method, headers, body: payload });
  const data = await r.json().catch(() => ({}));
  if (!r.ok) throw Object.assign(new Error(data.error ?? r.statusText), { code: data.code, status: r.status });
  return data;
}

// Step 1: the bytes. POST /files/<name> answers 201 {url, name}.
async function uploadFile(file) {
  const safeName = file.name.replace(/[^\w.]+/g, "-");            // the path segment; the served name gets a hash prefix
  return api("POST", `/files/${encodeURIComponent(safeName)}`, file);
}
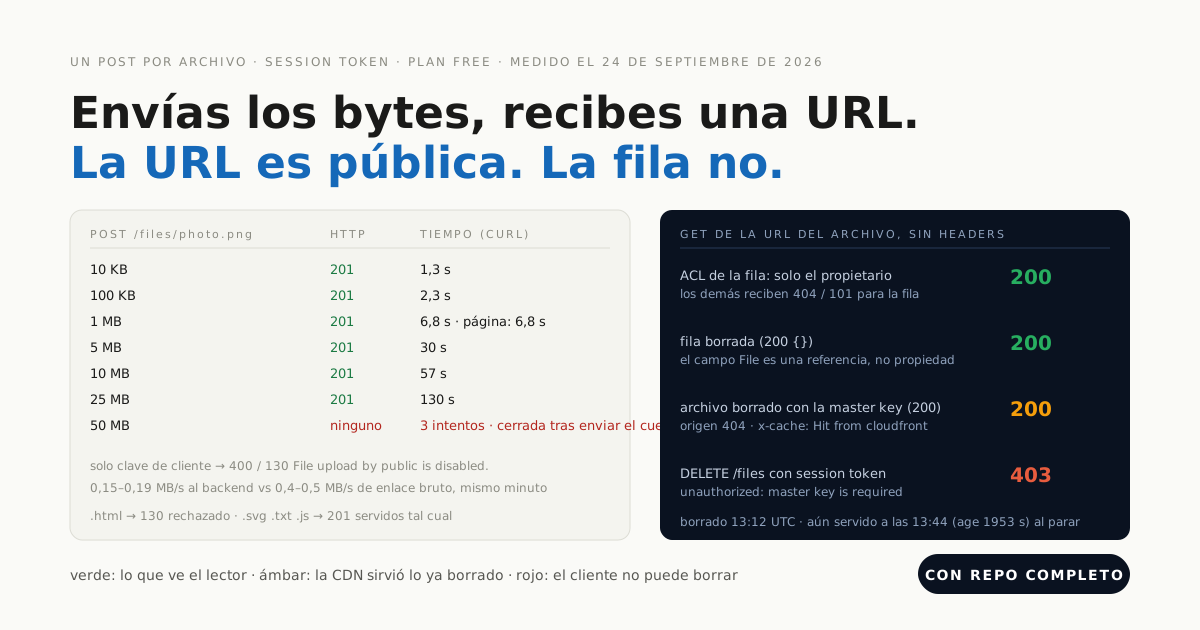
La página tiene un formulario de registro e inicio de sesión encima del campo de archivo por una razón que no habíamos planeado: la primera subida que intentamos, solo con el App ID y la JavaScript key, fue rechazada. 400, código 130, File upload by public is disabled. Los mismos bytes con un session token: 201. Con la master key: 201.
Así que la página inicia la sesión del usuario, guarda el token en sessionStorage y solo entonces muestra el input.
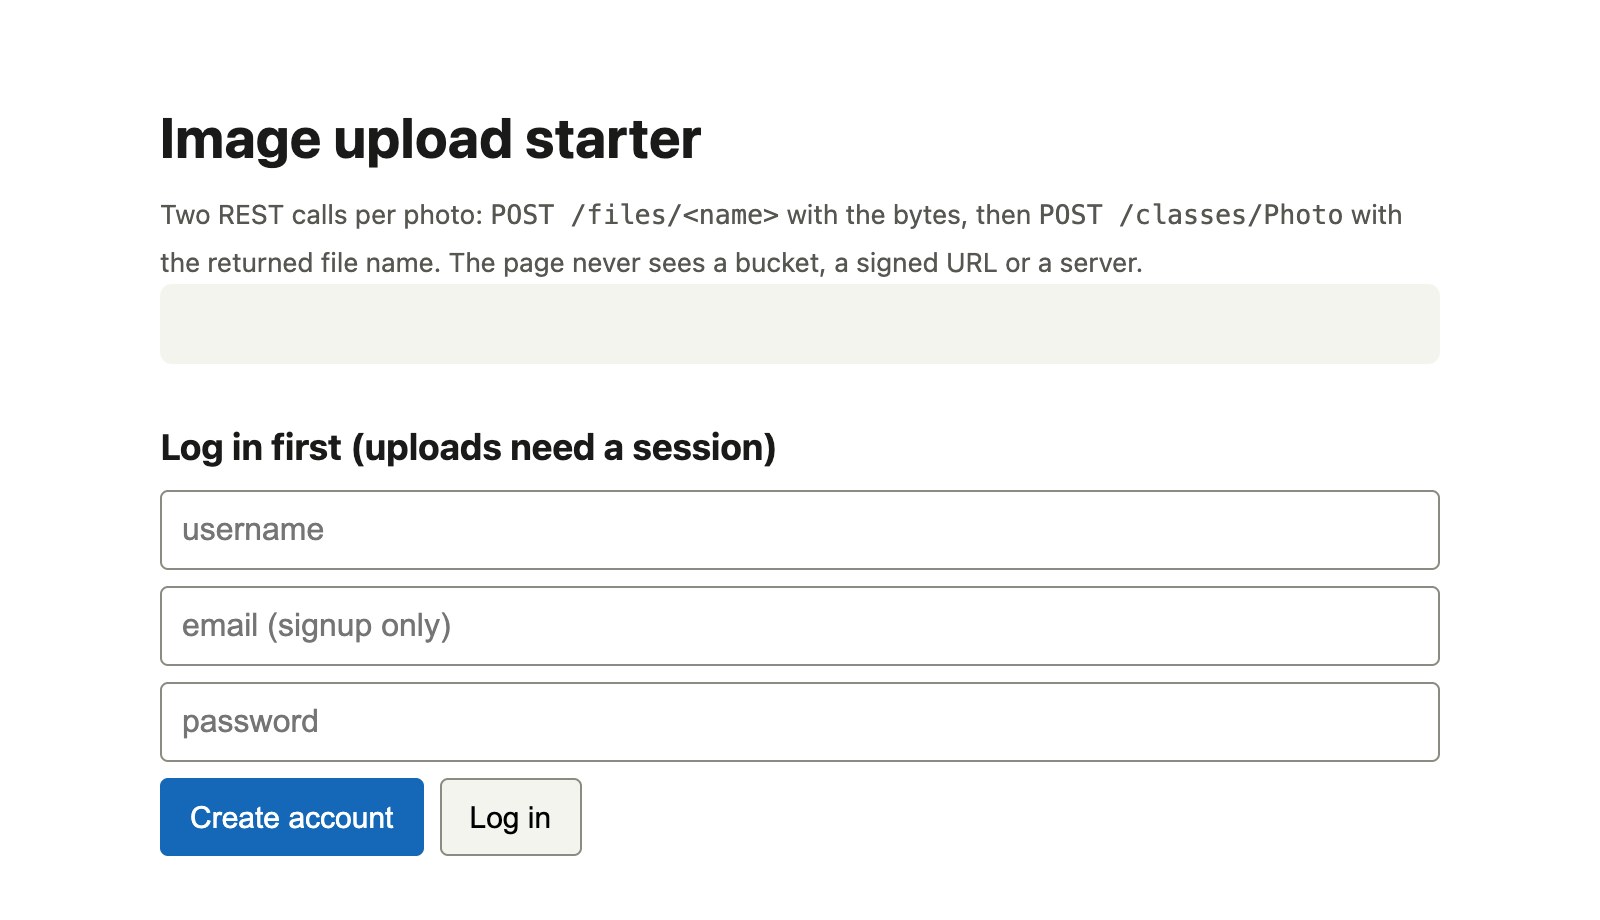
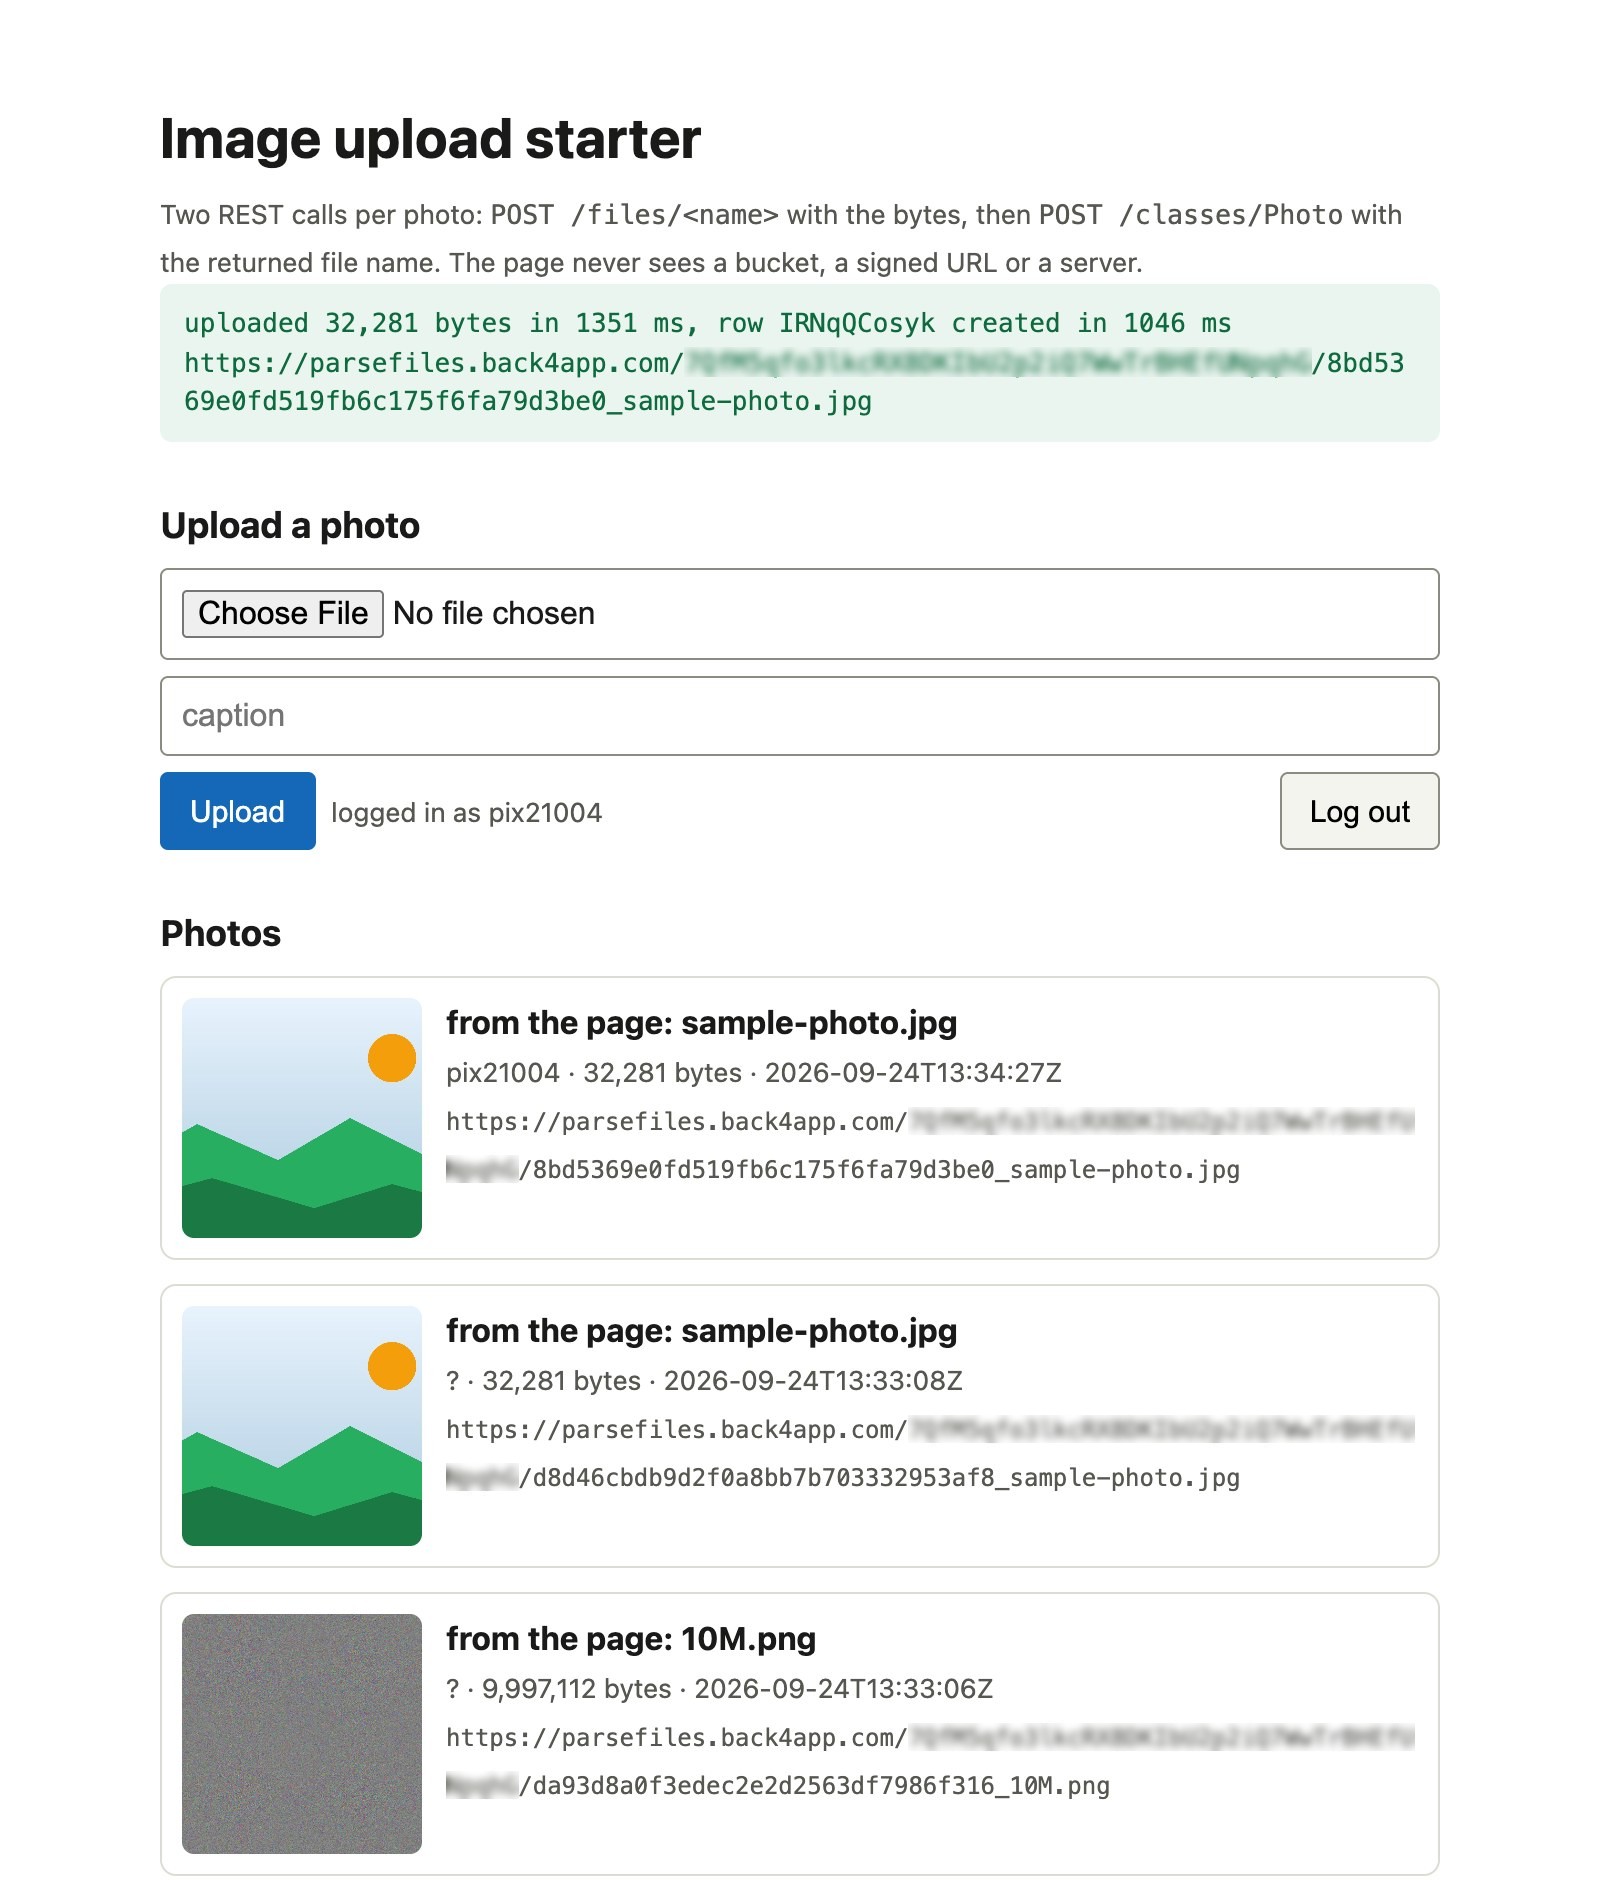
El manejador del submit envuelve las dos llamadas en performance.now() e imprime los dos tiempos en la barra de estado, que es de donde salen los números de navegador de este post:
// Stack: vanilla JavaScript (browser) | File: web/app.js (upload handler)
$("#upload").addEventListener("submit", async (e) => {
  e.preventDefault();
  const file = e.target.file.files[0];
  const caption = e.target.caption.value.trim();
  if (!file) return;
  try {
    status(`uploading ${file.name} (${fmt(file.size)} bytes)…`);
    const t0 = performance.now();
    const stored = await uploadFile(file);                    // 201 {url, name}
    const t1 = performance.now();
    const photo = await createPhoto(stored, caption, file);   // 201 {objectId, createdAt}
    const t2 = performance.now();
    status(`uploaded ${fmt(file.size)} bytes in ${Math.round(t1 - t0)} ms, row ${photo.objectId} created in ${Math.round(t2 - t1)} ms\n${stored.url}`, "ok");
    e.target.reset(); await listPhotos();
  } catch (err) { status(`${err.code ?? err.status} ${err.message}`, "err"); }
});
Manejamos la página en Chrome headless con web-check.mjs, que crea la cuenta, pone un archivo real en el input a través del protocolo de DevTools y hace clic en el botón, así que los tiempos son los de la propia página.
Los números de la página siguen a los de curl con menos de un segundo de diferencia en todos los tamaños: 1,21 s para 10 KB, 1,68 s para 100 KB, 6,84 s para 1 MB, 28,6 s para 5 MB y 54,8 s para 10 MB, con el POST de la fila después entre 0,7 s y 2,2 s. La barra de estado imprime los dos y la URL completa.
¿Cómo vinculas el archivo a una fila Photo y a su propietario?
Con un segundo POST, a /classes/Photo, cuyo campo image es un valor File: { "__type": "File", "name": "<el name del paso 1>", "url": "<la url del paso 1>" }. El backend resuelve el nombre a la URL cada vez que lees la fila; la url va en la solicitud porque el backend la necesita en cuanto un trigger se ejecuta en la clase, como se mide más abajo.
owner es un pointer al usuario con sesión iniciada, y la ACL dice quién puede modificar la fila:
// Stack: vanilla JavaScript (browser) | File: web/app.js (the row)
// Step 2: the row. A File field references the stored file by name. Send the url from step 1 as well (see the finding
// in the deletion section: with a trigger on the class, name alone answered 502).
async function createPhoto({ name, url }, caption, file) {
  return api("POST", "/classes/Photo", {
    caption,
    image: { __type: "File", name, url },
    contentType: file.type,
    size: file.size,
    owner: { __type: "Pointer", className: "_User", objectId: me.objectId },
    ACL: { "*": { read: true }, [me.objectId]: { read: true, write: true } },
  });
}
Listar es un GET /classes/Photo?order=-createdAt&include=owner, y cada resultado lleva image: { __type: "File", name, url }. La página pone url en un <img src>; la CDN hace el resto. No definimos la clase ni ninguna columna a mano: el primer POST creó Photo con caption, image, contentType, size y owner, tipadas a partir de los valores que enviamos.
Una cosa que la captura muestra y que el código no pretendía: el autor aparece como ? en las fotos de otros usuarios. include=owner expande el pointer solo cuando quien llama puede leer la fila de ese usuario, y en este backend un usuario que lee la fila de otro recibió 404 / 101, con session token o sin él. Si el nombre importa, guárdalo como string en la fila Photo al subir.
Dos decisiones van incrustadas en esa ACL y las dos pertenecen al backend, no a la página. Un comando curl puede enviar el owner y la ACL que quiera con la misma clave de cliente.
El cloud/main.js del repositorio tiene un beforeSave("Photo") que sobrescribe los dos a partir de request.user, exactamente como hace la clase Note en el post sobre cómo proteger el backend. La sección sobre el borrado, más abajo, cuenta qué hace y qué pasó cuando lo desplegamos.
¿Qué tamaño puede tener un archivo y cuánto tarda una subida?
Más grande de lo que esperábamos, y más lento que la conexión. Generamos PNG reales de seis tamaños (píxeles aleatorios, guardados sin comprimir, para que el recuento de bytes fuera el que pedimos) y enviamos cada uno con un POST desde curl, con session token y Content-Type: image/png. Todos devolvieron 201:
| Tamaño (bytes enviados) | HTTP | Tiempo, curl (mediana de 3, rango) | Tiempo, página web | POST de la fila después |
|---|---|---|---|---|
| 10 KB (9.872) | 201 | 1,33 s (1,21–1,38) | 1,21 s | 1,10 s |
| 100 KB (99.649) | 201 | 2,33 s (2,06–3,08) | 1,68 s | 2,05 s |
| 1 MB (999.762) | 201 | 6,78 s (6,77–7,18) | 6,84 s | 0,72 s |
| 5 MB (4.995.285) | 201 | 29,5 s (27,8–31,5) | 28,6 s | 0,71 s |
| 10 MB (9.997.112) | 201 | 56,6 s (53,2–65,5) | 54,8 s | 2,17 s |
| 25 MB (24.998.119) | 201 | 130 s (una ejecución) | – | – |
| 50 MB (50.008.266) | ninguno | 200–329 s, después la conexión se cerró, 3 de 3 | – | – |
Cómo lo medimos: curl -w '%{time_total} %{speed_upload}' alrededor de cada POST, desde el primer byte de la solicitud hasta el último byte del 201. La mediana de tres ejecuciones por tamaño de 10 KB a 10 MB (iniciadas a las 13:08, 13:39 y 13:41 UTC) y una ejecución para 25 MB (13:09 UTC), desde un portátil al backend de USA East, plan Free, el 24 de septiembre de 2026.
La columna del navegador es performance.now() alrededor de cada fetch en web/app.js, una ejecución por tamaño a las 13:31–13:33 UTC, leída de la barra de estado de la página por web-check.mjs en Chrome 154 headless.
Los tiempos absolutos son los de nuestro enlace de subida. En los mismos minutos, el mismo archivo de 10 MB fue a dos endpoints de prueba de ancho de banda sin relación a 0,49 MB/s y 0,38 MB/s, frente a 0,15 a 0,19 MB/s hacia el backend.
El archivo de 50 MB es la única fila sin status. Dos veces sobre HTTP/2, curl informó Error in the HTTP2 framing layer tras 321 s y 329 s; una vez sobre HTTP/1.1 recibió 100 Continue, lo envió todo y tras 200 s recibió Empty reply from server. Los 50.008.266 bytes salieron del portátil cada vez.
Eso es un límite entre 25 y 50 MB o un timeout de solicitud de unos minutos; el backend no dijo cuál, así que nosotros tampoco.
Así que en esta conexión la ruta de subida fue a cerca de la mitad del enlace en bruto, lo que encaja con un backend que recibe el cuerpo entero antes de escribirlo en el almacén y responder. Presupuesta más o menos el doble de lo que tardaría una subida simple de los mismos bytes, y muestra el progreso.
¿Quién puede leer la URL del archivo cuando la fila es de solo propietario?
Todo el mundo. Era la medición que más queríamos, y la respuesta es clara: la ACL protege la fila, y la URL no es la fila. Creamos una Photo cuya ACL concedía lectura y escritura solo al propietario, referenciando el archivo de 1 MB, y la pedimos de tres formas:
| Solicitud | Respuesta |
|---|---|
anónimo (App ID + JavaScript key) → GET /classes/Photo/2VU6ud9qUs | 404 {"code":101,"error":"Object not found."} |
propietario (session token) → GET /classes/Photo/2VU6ud9qUs | 200 |
cualquiera, sin ningún header → GET <la URL del archivo> | 200 image/png 999762 bytes |
La fila se oculta. El archivo no, porque la solicitud del archivo nunca llega al backend: va a la CDN, que no sabe nada de _User, de sesiones ni de ACL. A nada en esa ruta se le puede pedir que compruebe algo.
Eso también decide qué va en el archivo. Subimos un .txt, un .svg, un .js y un blob sin nombre y sin ningún Content-Type; los cuatro volvieron 201, y cada URL se sirvió exactamente con el tipo que enviamos. Un PNG subido como image/jpeg se sirvió como image/jpeg. Nada inspeccionó los bytes.
El único rechazo fue .html: 130 File upload of extension html is disabled., que es el backend evitando que una página con tu App ID en la URL aloje el script de otro.
¿Qué pasa con el archivo cuando borras la fila?
Nada. Ese es el hallazgo que dio forma al resto del repositorio. El propietario borró la fila Photo, 200 {}, y dos segundos después la URL del archivo seguía respondiendo 200 image/png 999762 bytes. La fila y el archivo son dos objetos con dos vidas, y el campo File es una referencia, no propiedad.
Así que intentamos borrar el archivo. DELETE /files/<name> con el session token: 403 {"error":"unauthorized: master key is required"}. Con la JavaScript key: el mismo 403. Con la master key: 200. Después la URL otra vez, dos segundos más tarde: 200, el archivo entero. Diez segundos después: 200.
La ruta de origen en el host de la API, GET /files/<APP_ID>/<name>, decía 404; la URL pública decía x-cache: Hit from cloudfront y un age que no dejaba de subir. Seguimos sondeando cada dos minutos. A las 13:44 UTC, 32 minutos después del borrado, la URL seguía devolviendo 200 con age: 1953, y seguía haciéndolo cuando dejamos de mirar.
| Paso | Respuesta |
|---|---|
propietario → DELETE /classes/Photo/<id> | 200 {} |
GET <URL del archivo> 2 s después | 200 image/png, todos los bytes |
session token → DELETE /files/<name> | 403 unauthorized: master key is required |
JavaScript key → DELETE /files/<name> | 403 unauthorized: master key is required |
master key → DELETE /files/<name> | 200 |
GET /files/<APP_ID>/<name> en el host de la API | 404 |
GET <URL del archivo> (CDN), 2 s / 10 s / 32 min después | 200, x-cache: Hit from cloudfront, age en aumento |
GET <URL del archivo>?v=2 | 200, la misma copia en caché |
Cómo lo medimos: pasos 7 y 8 de upload-check.sh, una ejecución a las 13:12 UTC del 24 de septiembre de 2026, y después un poller que descargaba la URL borrada cada dos minutos y registraba el status y los headers x-cache y age, desde un portátil a través de un solo edge de la CDN (el header x-amz-cf-pop decía MIA50).
Dos consecuencias. Un cliente no puede borrar un archivo, así que “quitar mi foto” tiene que ejecutarse en el backend. Y “borrado” significa que el origen olvidó el objeto mientras el edge lo sigue sirviendo, sin header cache-control que lo acorte y sin query string que lo invalide: la solicitud ?v=2 fue un hit sobre la misma copia.
Si el archivo se subió por error, cuenta con que seguirá accesible desde ese edge durante un tiempo después de borrarlo.
¿Cómo haces que una fila borrada se lleve su archivo?
Con un hook beforeDelete sobre Photo en Cloud Code, que es el único lugar que puede tener la master key. Se ejecuta en el backend para cada borrado, lo pida el cliente que lo pida, lee el campo image y destruye el archivo antes de que la fila desaparezca:
// Stack: Node.js 22.x | Parse Server 7.x (Cloud Code) | File: cloud/main.js
// Rule 1: a Photo belongs to whoever uploaded it, whatever the client claimed. Anyone may read the row; only the owner
// may change or delete it. Set here, on the backend, so a curl command cannot skip it.
Parse.Cloud.beforeSave("Photo", (request) => {
  const photo = request.object;
  if (!photo.isNew()) return;
  const owner = request.user;
  if (!owner) throw new Parse.Error(Parse.Error.SESSION_MISSING, "log in to upload a photo.");
  if (!photo.get("image")) throw new Parse.Error(Parse.Error.VALIDATION_ERROR, "a Photo needs an image.");
  photo.set("owner", owner);
  const acl = new Parse.ACL();
  acl.setPublicReadAccess(true);
  acl.setWriteAccess(owner, true);
  photo.setACL(acl);
});

// Rule 2: deleting the row deletes the file. DELETE /files/<name> needs the master key, which lives here and nowhere else.
Parse.Cloud.beforeDelete("Photo", async (request) => {
  const file = request.object.get("image");
  if (!file) return;
  try {
    await file.destroy({ useMasterKey: true });
  } catch (err) {
    // A file that is already gone must not block the row delete; anything else should.
    if (err.code !== Parse.Error.FILE_DELETE_ERROR && err.code !== Parse.Error.OBJECT_NOT_FOUND) throw err;
  }
});
file.destroy({ useMasterKey: true }) es el mismo DELETE /files/<name> que enviamos desde la terminal, emitido desde dentro del backend con la clave que el cliente nunca tuvo. El beforeSave de encima es la otra mitad: owner y la ACL salen de request.user, así que los valores de la propia página se sobrescriben y un comando curl no puede reclamar la cuenta de otro.
Cloud Code se despliega desde la dashboard (Cloud Code → main.js → Deploy, dos veces en un backend recién creado: el primer deploy no envía nada, un comportamiento que ya habíamos visto en siete backends antes de este).
El hook-check.sh del repositorio es la prueba: dos usuarios, una subida, una fila creada a propósito con el owner equivocado y una ACL abierta, después el borrado por el propietario y un GET de la ruta de origen del archivo, que debe ser 404.
Esta es la ejecución, a las 14:38 UTC del 24 de septiembre de 2026, con el archivo desplegado. ana subió un archivo y después creó una fila que reclamaba owner = bob y una ACL de escritura pública. La fila volvió con owner = ana y ACL {"*":{"read":true},"<ana>":{"write":true}}: la reclamación del cliente fue sobrescrita.
Después la borró, sin nada más que su session token:
| Paso | Respuesta |
|---|---|
anónimo → POST /classes/Photo con una imagen | 400 {"code":206,"error":"log in to upload a photo."} |
ana → POST /classes/Photo, el cuerpo reclama owner: bob, ACL: {"*": read+write} | 201, guardado owner: ana, ACL {"*":{"read":true},"ana":{"write":true}} |
bob → PUT / DELETE de esa fila | 404 / 101 Object not found. / Object not found for delete. |
ana → POST /classes/Photo sin imagen | 400 / 142 a Photo needs an image. |
| antes del borrado: ruta de origen / URL de la CDN | 200 / 200 image/png |
ana → DELETE /classes/Photo/sSo3LhjDmY | 200 {} |
2 s y 12 s después: ruta de origen GET /files/<APP_ID>/<name> | 404 |
| 2 s y 12 s después: URL de la CDN | 403, x-cache: Error from cloudfront |
Cómo lo medimos: hook-check.sh, una ejecución a las 14:38:05–14:38:39 UTC del 24 de septiembre de 2026, dos usuarios recién creados, curl desde un portátil; después un borrado con la master key a las 14:39 de una fila que la página había creado antes de que existiera el hook, que también devolvió 200 y dejó la ruta de origen en 404.
La línea de la CDN difiere del hallazgo anterior, y la diferencia es instructiva. Este archivo se había descargado una vez a través de la CDN antes del borrado (x-cache: Miss), y después del borrado el edge respondió 403 de inmediato.
El archivo de 1 MB de la mañana se había descargado varias veces (Hit), y su copia en caché siguió sirviéndose durante 32 minutos después de su borrado. Lo que el edge ya tiene, lo conserva; lo que no ha guardado, lo va a buscar al origen.
La misma solicitud con la url de la respuesta de subida respondió 400 / 206 o 201, como debía, y lo mismo un cuerpo sin ningún image.
Antes de que existiera el trigger, name a solas había funcionado toda la mañana: la página y el script crearon todas las filas así. Envía name y url, exactamente como respondió la subida; la página y los dos scripts ya lo hacen.
El hallazgo explica un tramo feo que tenemos que reconocer. Durante unos diez minutos después del deploy de Cloud Code (14:11–14:24 UTC) la app se reinició una y otra vez y cada escritura en Photo respondió 502, mientras el log System de la dashboard mostraba los reinicios y el log Error no mostraba nada salvo nuestras propias entradas 142.
Nuestro primer script de prueba envió name a solas, treinta veces, y cada intento reinició la app; si lo empezó el deploy o nuestros reintentos, no podemos decirlo.
¿Con qué errores de subida te vas a encontrar y qué dicen sus cuerpos?
Todos los rechazos que encontramos el 24 de septiembre de 2026 llegaron como un status HTTP más un cuerpo JSON; ramifica por el code, y por el texto de error en los dos que comparten el 130:
| Qué hiciste | HTTP | code | error |
|---|---|---|---|
POST /files/<name> solo con el App ID y una clave de cliente | 400 | 130 | File upload by public is disabled. |
POST /files/probe.html (session token) | 400 | 130 | File upload of extension html is disabled. |
DELETE /files/<name> con un session token o una clave de cliente | 403 | – | unauthorized: master key is required |
GET /classes/Photo/<id> de una fila que tu ACL no puede leer | 404 | 101 | Object not found. |
GET /files/<APP_ID>/<name> en el host de la API después de borrar el archivo | 404 | – | Not Found (texto plano) |
GET /files con la master key (no hay endpoint de listado) | 404 | – | {"message":"Not Found","error":{}} |
POST /classes/Photo con image: {"__type":"File","name":…} y sin url, cuando existe un trigger en la clase | 502 | – | Bad Gateway (texto plano), después /health 502 durante un segundo |
POST /classes/Photo sin sesión, con el hook desplegado | 400 | 206 | log in to upload a photo. |
POST /classes/Photo sin image, con el hook desplegado | 400 | 142 | a Photo needs an image. |
130 File upload by public is disabled. es el que tu formulario encontrará primero. La solución es una sesión, no una clave: registra al usuario o inicia su sesión, envía X-Parse-Session-Token con el POST y mantén la master key fuera de la página. El starter muestra el input de archivo solo después de que GET /users/me haya aceptado el token.
130 File upload of extension html is disabled. va por nombre, no por tipo: los mismos bytes que probe.txt con Content-Type: text/html fueron aceptados. Renombra o rechaza en la página, y no esperes que el backend rechace un script por su contenido: probe.js pasó como text/javascript.
502 Bad Gateway al guardar una Photo, con la app brevemente sin salud después, es el caso del File sin url de la sección del borrado. Envía {"__type":"File","name","url"} exactamente como respondió la subida, y nunca reintentes un 502 en bucle: cada uno reinicia la app.
Un 201 con el Content-Type equivocado es el error que no verás. La URL sirve el tipo que enviaste, sea cual sea, así que lee file.type del objeto File y rechaza en la página, antes de subir, todo lo que no sea image/*.
Es lo que el accept="image/*" del input hace para una persona y una comprobación de dos líneas hace para un script.
¿Cuándo sí quieres almacenamiento de objetos?
Cuando el archivo es el producto, o la URL debe caducar. Tres casos en los que un bucket que administras tú, o un servicio de archivos dedicado, gana al endpoint de archivos:
- Archivos muy grandes. Nuestra subida de 25 MB tardó 130 s en una sola solicitud por un enlace lento, sin reanudación, y la de 50 MB nunca obtuvo respuesta. Video, fotos en RAW y exportaciones piden subidas multiparte y reanudables, con progreso por parte, que la API de un bucket y una librería cliente para el navegador te dan y un solo
POSTno. - URLs firmadas con caducidad. Aquí un archivo es público hasta que se borra, y queda en caché más allá. Descargas de pago, imágenes médicas, contratos, cualquier cosa en la que la URL deba dejar de funcionar en un momento que eliges tú, necesita URLs firmadas con caducidad, es decir, un almacén de objetos y un servidor o una función que firme.
- Transformaciones al vuelo. Miniaturas, redimensionado, conversión de formato, marcas de agua: una CDN de imágenes lo hace desde un parámetro de la URL. Aquí subes los tamaños que necesitas (la página puede redimensionar en un
<canvas>antes delPOST) y referencias cada uno desde la fila.
Para avatares, fotos de anuncios, adjuntos y cualquier cosa que un usuario acepte tener en una URL pública, las dos llamadas de arriba son la funcionalidad completa, y la parte que te toca mantener son 32 líneas de Cloud Code.
¿Qué añadirías al image upload starter a continuación?
- Redimensiona en el navegador. Dibuja la imagen en un
<canvas>a 1600 px,toBlob("image/webp", 0.85)y sube eso: nuestra foto de móvil de 5 MB se convierte en una subida de 300 KB, y la tabla de tiempos de arriba se encoge con ella. - Progreso.
fetchno puede informar del progreso de subida;XMLHttpRequestsí. CambiauploadFilepor una versión conxhr.upload.onprogressy muestra una barra, que los 57 s de los 10 MB se merecen. - Un job de limpieza. Los archivos subidos cuya creación de fila falló (el segundo
POSTpuede fallar después de que el primero tuvo éxito) son huérfanos que nadie referencia. Un Cloud Job programado que liste las filasPhotoy borre con la master key los archivos no referenciados mantiene honesto el 1 GB. - Archivos privados. Una clase
Documentcon una ACL de solo propietario y una Cloud Functiondownload(id)que comprueberequest.usery devuelva los bytes con la master key: el patrón del contracaso, en este backend. - Usuarios primero, permisos después. La página necesita cuentas porque las subidas necesitan una sesión: eso es el post de autenticación. Quién puede leer y escribir las filas
Photo, con una sonda que puedes volver a ejecutar, es el post sobre cómo proteger el backend.